大模型应用 - 进阶
本文目录
一、大模型基础
注意力机制
1. 多头注意力的实现
主线见大模型应用 · 多头注意力,那里以 Qwen2.5-7B 为例给出了各步的形状变化。
手写的实现如下(PyTorch,与 torch.nn.MultiheadAttention 用同一组权重对照,最大误差为 1.8 × 10⁻⁷,见附录 A1):
class MHA(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        self.h, self.dk = n_heads, d_model // n_heads
        self.qkv = nn.Linear(d_model, 3 * d_model)    # 一次算出 Q、K、V
        self.out = nn.Linear(d_model, d_model)

    def forward(self, x):                              # x: (B, n, d_model)
        B, n, d = x.shape
        q, k, v = self.qkv(x).split(d, dim=-1)
        # (B, n, d) -> (B, n, h, dk) -> (B, h, n, dk):每个头只用其中 dk 维
        q, k, v = [t.view(B, n, self.h, self.dk).transpose(1, 2) for t in (q, k, v)]
        scores = q @ k.transpose(-2, -1) / self.dk ** 0.5            # (B, h, n, n)
        mask = torch.ones(n, n, dtype=torch.bool).triu(1)            # 因果掩码:右上角
        scores = scores.masked_fill(mask, float("-inf"))
        o = scores.softmax(dim=-1) @ v                                # (B, h, n, dk)
        o = o.transpose(1, 2).contiguous().view(B, n, d)              # 拼接各头
        return self.out(o)
拼接之前要调用 contiguous(),这是因为 transpose 只改变了张量各维的步长,数据在内存中仍按原来的顺序排列,这时直接调用 view 会报错。contiguous() 按新的顺序复制一份连续的数据,也可以直接用 reshape,它在需要时自动复制。
2. 计算量与 FlashAttention
主线见大模型应用 · 计算量与 FlashAttention。
按 Qwen2.5-7B 的配置计算,每个 Token 经过一层的线性层约需 4.7 亿次浮点运算,与上下文长度无关;生成第 T 个 Token 时,一层注意力的分数和加权求和约需 14336 × T 次,T 约为 3.2 万时两者相当(见附录 A2)。
序列长度为 n 时,标准实现分几步完成:算出 n × n 的分数矩阵写入显存,读出来做 softmax 再写回,再读出来乘以 V。GPU 的显存(HBM)容量大但带宽有限,A100 为 1.5~2.0 TB/s;每个计算单元旁边的片上缓存(SRAM)带宽约 19 TB/s,但总共只有约 20 MB。这个矩阵又很大,n = 32K 时,Qwen2.5-7B 一个头的分数矩阵在 BF16 下就占 2 GB,大部分时间花在了读写显存上。
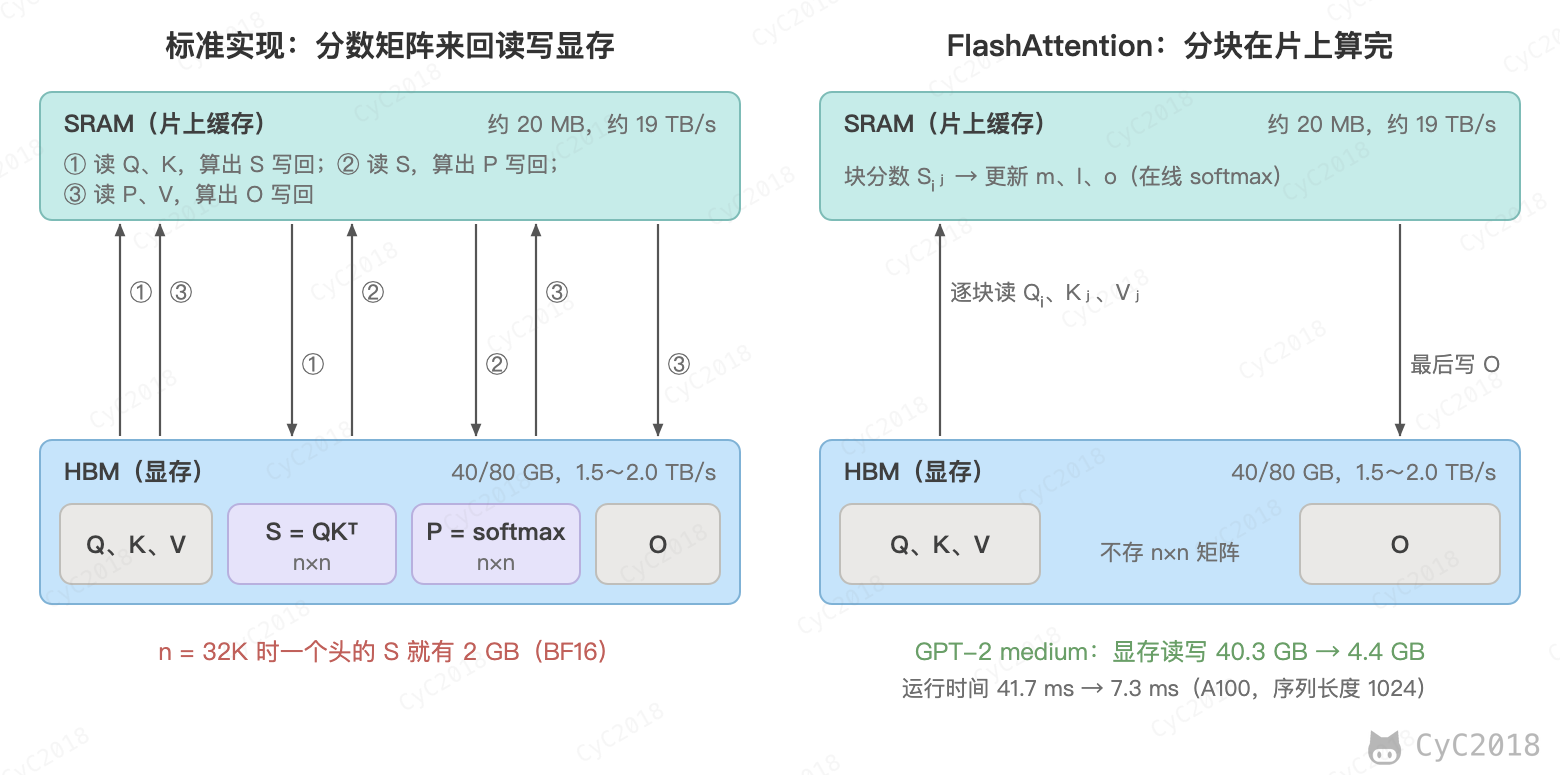
FlashAttention 把计算分块:每次把一块 Q 和一块 K、V 读入 SRAM,算出这一块的分数后直接累积到输出中,n × n 的矩阵从不写回显存。难点在于 softmax 要除以全部分数的指数和,只看到一部分 K 时还不知道这个和。解决方法是在线 softmax:对每个查询维护目前为止的最大分数 m、指数和 l 以及未归一化的输出 o,读入新的一块后,如果最大值变大了,就把之前的 l 和 o 乘以 em旧 − m新 再累加。例如一个查询与 4 个 Token 的分数为 2、1、3、0,对应的 V 为 10、20、30、40,每块 2 个 Token:
第 1 块(分数 2、1)  m = 2   l = e^0 + e^-1 = 1.368
                      o = 10 × e^0 + 20 × e^-1 = 17.358
第 2 块(分数 3、0)  m = 3   之前的 l 和 o 乘以 e^(2-3) = 0.368
                      l = 1.368 × 0.368 + e^0 + e^-3 = 1.553
                      o = 17.358 × 0.368 + 30 × e^0 + 40 × e^-3 = 38.377
输出 o / l = 24.711,与一次性做 softmax 的结果相同
所以 FlashAttention 是精确计算,而不是近似(numpy 实测,见附录 A2)。反向传播时也不保存分数矩阵,只保存 m 和 l,需要时重新计算分数,多做了一些计算,但显存的读写更少,整体仍然更快。论文在 A100 上计算 GPT-2 medium 的注意力(序列长度 1024),浮点运算量从 66.6 G 增加到 75.2 G,显存读写却从 40.3 GB 降到 4.4 GB,运行时间从 41.7 毫秒降到 7.3 毫秒。FlashAttention-2 进一步减少了矩阵乘法以外的运算,并沿序列长度的方向并行,速度又提高了约 1 倍。
3. 旋转位置编码与长度外推
主线见大模型应用 · 注意力机制。以 Qwen2.5-7B 为例,每个头 128 维分成 64 组,base = 106,各组的波长(转一圈需要的 Token 数)从 6.28 到约 506 万。按训练长度 32768,64 组分成三类(见附录 A4):
- 24 组转了 32 圈以上,各种角度在训练中都出现过;
- 24 组转不满一圈;
- 其余 16 组介于两者之间。
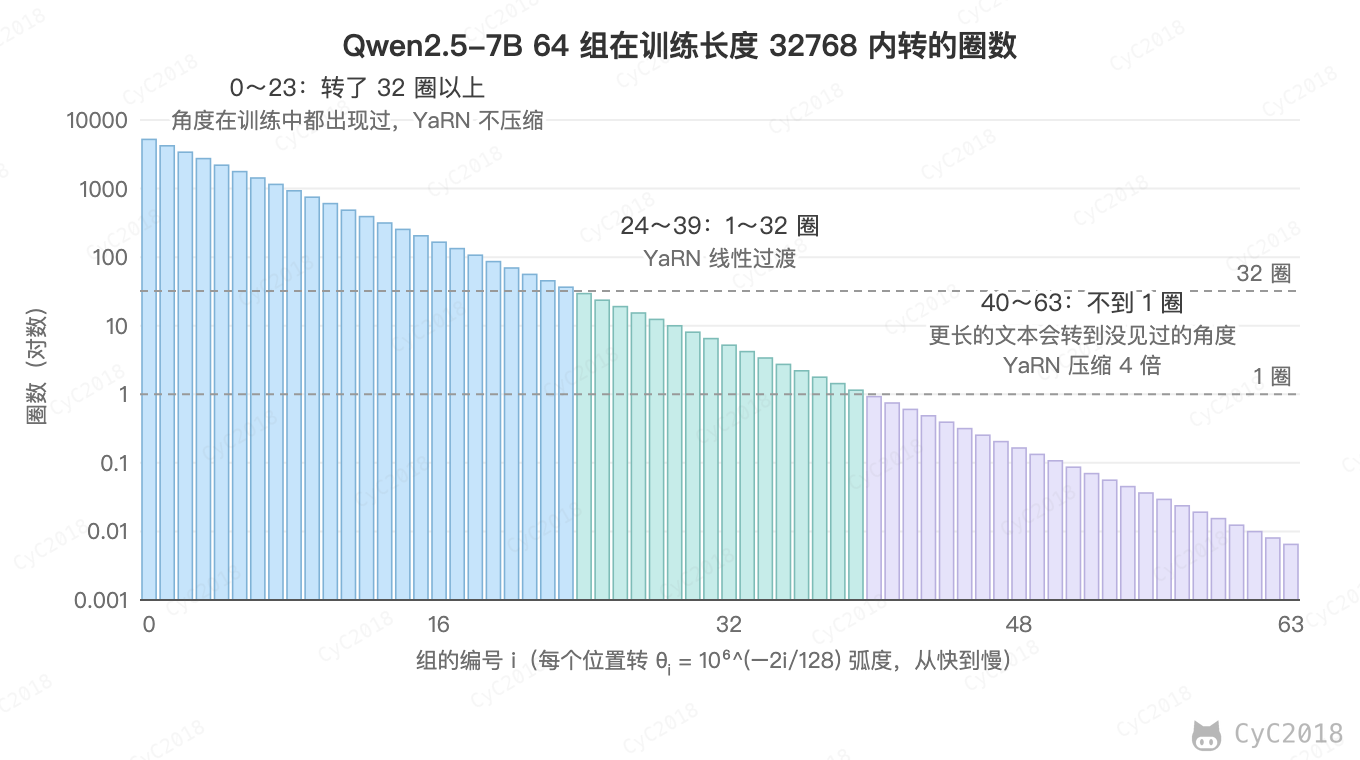
直接输入更长的文本时,问题出在转不满一圈的组:例如最慢的一组在训练中最多转到 0.041 弧度,位置 131071 要转到 0.163 弧度,模型从没见过这样的角度,困惑度迅速上升。
位置插值(Position Interpolation, PI)把所有位置按比例压缩,例如扩展 4 倍时把位置 131071 当作 32767.8 计算,角度都落回训练过的范围,论文用它把 LLaMA 扩展到 32768,微调不到 1000 步。缺点是转得快的组也被压缩了,相邻 Token 在第 0 组的角度差从 1 弧度变成 0.25 弧度,近处的 Token 更难区分。
YaRN 按组区别处理:转 32 圈以上的组不压缩,转不满一圈的组按 PI 的方式压缩,中间的组线性过渡;另外把注意力分数乘以一个随扩展倍数增大的系数,扩展 4 倍时约为 1.30。Qwen2.5-7B-Instruct 在 config.json 中加入 rope_scaling(type 为 yarn,factor 为 4.0,original_max_position_embeddings 为 32768)后,可以从 32K 扩展到 128K;vLLM 只支持静态 YaRN,倍数不随输入长度变化,可能影响短文本的效果,所以只在需要处理长文本时开启。
自回归生成与 KV Cache
1. 带 KV Cache 的 GQA
带 KV Cache 的 GQA 在解码时每一步只输入新的 Token,把它的 K、V 追加到缓存末尾,再与缓存中的全部 K、V 计算注意力:
k = torch.cat([cache["k"], k_new], dim=2)    # (B, KV 头数, 已有长度 + 1, 每个头的维度)
v = torch.cat([cache["v"], v_new], dim=2)
cache["k"], cache["v"] = k, v                 # 缓存的是 4 组 K、V,而不是 28 个头
g = n_heads // n_kv_heads                      # 每组 K、V 由 g 个查询头共用
k, v = k.repeat_interleave(g, dim=1), v.repeat_interleave(g, dim=1)
o = (q_new @ k.transpose(-2, -1) / dk ** 0.5).softmax(-1) @ v    # 新 Token 可以看到全部前文,不需要掩码
这样逐个 Token 解码的结果与整段一次计算的结果一致,最大误差为 1.9 × 10⁻⁷(完整代码见附录 A1)。
2. 多头潜在注意力
主线见大模型应用 · 自回归生成与 KV Cache中减少 KV Cache 的方法。
MLA 只缓存每个 Token 压缩后的低维潜在向量,计算时用矩阵还原出各个头的 K、V。推理时这些还原矩阵可以合并到 Q 和输出的矩阵中,不必真的算出每个头的 K、V。RoPE 会妨碍这种合并,所以另用一个所有头共享的小向量携带位置信息。DeepSeek-V3 每层每个 Token 只缓存 512 维的潜在向量和 64 维的位置向量,共 576 个数,61 层共 68.6 KB;同样的 128 个头如果用 MHA,每个 Token 要 4.77 MB(按 config.json 计算,见附录 A3)。DeepSeek-V2 论文中 MLA 的缓存量只相当于 2.25 组的 GQA,效果却好于 MHA。
训练过程
1. 广义优势估计
主线见大模型应用 · RLHF 与 PPO,这里展开 PPO 中每个 Token 的优势怎样计算。
把生成过程看作强化学习:状态是提示词和已经生成的 Token,动作是下一个 Token,奖励模型的分数在回答结束时才给出。每个 Token 的优势用广义优势估计(Generalized Advantage Estimation, GAE)计算:先算每一步的时序差分误差 δt = rt + γV(st+1) − V(st),即走完这一步后价值模型的估计比之前高了多少,优势是之后各步 δ 的加权和 Σ (γλ)k δt+k。
λ = 0 时只看一步,依赖价值模型的估计,方差小但有偏差;λ = 1 时等于之后各步奖励的折扣和减去 V(st),没有偏差但方差大;λ 取两者之间的值来折中。例如一个 3 个 Token 的回答在结尾得到奖励 1,取 RLHF 中常用的 γ = 1,暂不考虑 KL 惩罚,价值模型对三个状态的估计依次为 0.5、0.6、0.8:
三步的 δ   0 + 0.6 − 0.5 = 0.1    0 + 0.8 − 0.6 = 0.2    1 + 0 − 0.8 = 0.2
第 1 个 Token 的优势:
  λ = 0     0.1
  λ = 1     0.1 + 0.2 + 0.2 = 0.5,等于最终得分 1 减去 V(s0) = 0.5
  λ = 0.95  0.1 + 0.95 × 0.2 + 0.95² × 0.2 = 0.471
2. GRPO 的改进
大规模训练推理模型时,GRPO 暴露出几个问题,后续的算法分别做了改进:
- 全对或全错的题没有梯度:模型越学越好,全对的题越来越多,一批中有效的题目越来越少。DAPO 的动态采样多采一些题,丢掉全对和全错的,直到填满一批;
- 熵坍塌(Entropy Collapse):模型输出的熵在训练中很快下降,同一道题的多个回答几乎一样,失去了探索新解法的能力。原因之一是概率之比的上限:ε = 0.2 时,概率为 0.9 的 Token 一次可以升到 1,而概率为 0.01 的 Token 最多只能升到 0.012。DAPO 把上下限分开,下限仍为 0.2,上限放宽到 0.28;
- 长度偏差:GRPO 先在每个回答内部按 Token 数求平均,长回答中每个 Token 的权重变小,错误的长回答受到的惩罚被稀释,回答越来越长。DAPO 改为把一批中所有回答的 Token 放在一起平均;
- MoE 模型训练不稳定:每次更新后,同一个回答激活的专家会发生变化,Qwen3-30B-A3B 中约 10% 不同,按 Token 计算的概率之比剧烈波动。GSPO 改为按整个回答计算概率之比(取每个 Token 概率之比的几何平均),并对整个回答截断,Qwen3 的后续版本使用了这种方法。
DAPO 还去掉了 KL 项,理由是训练长推理时模型本来就要远离初始模型。它用 Qwen2.5-32B 基座模型在 AIME 2024 上达到 50 分,最初直接使用 GRPO 时只有 30 分。
微调
1. ZeRO 与 FSDP
主线见大模型应用 · QLoRA 与全参数微调,这里展开全参数微调时怎样把模型状态分到多张卡上。
普通的数据并行在每张卡上保存完整的模型状态,增加卡数并不能减少每张卡的显存。DeepSpeed 的 ZeRO 把模型状态切分到各张卡上,按切分的内容分为三个阶段。以 Qwen2.5-7B 在 8 张卡上训练为例,只算模型状态,不含激活(见附录 A3):
| 阶段 | 切分的内容 | 每张卡的显存 |
|---|---|---|
| 普通数据并行 | 不切分 | 121.8 GB |
| ZeRO-1 | 优化器状态 | 41.9 GB |
| ZeRO-2 | 优化器状态、梯度 | 28.6 GB |
| ZeRO-3 | 优化器状态、梯度、参数 | 15.2 GB |
优化器状态每个参数占 12 字节,是模型状态中最大的部分,所以 ZeRO-1 的收益最明显。ZeRO-1、ZeRO-2 的通信量与普通数据并行相同;ZeRO-3 在每一层计算前都要从其它卡收集完整的参数,用完即丢弃,通信量约为 1.5 倍。PyTorch 的 FSDP 采用同样的思路,FULL_SHARD 对应 ZeRO-3,SHARD_GRAD_OP 对应 ZeRO-2。显存仍然不够时,还可以把参数或优化器状态卸载到 CPU 内存,代价是训练变慢。
量化
1. GPTQ 与 AWQ
主线见大模型应用 · GPTQ 与 AWQ,这里展开两种方法的具体做法。
GPTQ 逐层量化,每层按列逐个量化权重:每量化一列,就根据校准数据算出的二阶信息(输入的 XXT),调整还没有量化的那些列,抵消这一列产生的输出误差。论文中 175B 的模型在一张显卡上约 4 小时就能量化到 3~4 位。
AWQ(Activation-aware Weight Quantization)基于这样的观察:权重的重要程度不同,与较大的激活相乘的那部分权重对输出影响最大,只保护其中 1% 就能明显减小误差。但为个别通道保留 FP16 会形成混合精度,硬件上效率不高。AWQ 的做法是:
- 用校准数据统计每个输入通道激活的平均大小 sX;
- 量化之前把权重的第 j 个输入通道乘以 sj = sX,jα,推理时把输入的第 j 个通道除以 sj,乘积不变;
- 重要的通道被放大之后,相对的量化误差变小;在 [0, 1] 中搜索使输出误差最小的 α。
对 Qwen2.5-7B 第 14 层 q_proj 做每 128 个一组的 INT4 非对称量化,这样缩放之后输出的相对误差从 8.98% 降到 7.86%(α = 0.3,见大模型应用 · 附录 A18)。
附录:实测
以下实验在 Apple M1 Pro、macOS 上运行,软件版本见各条。
A1 多头注意力、GQA 与 KV Cache 的实现
环境:Apple M1 Pro,macOS 15.8.1,Python 3.13.7,PyTorch 2.8.0(CPU)。正文中的 MHA 类与 torch.nn.MultiheadAttention 复制同一组权重后对照;下面的 GQA 类带 KV Cache,先预填充 5 个 Token,再逐个输入 7 个 Token,与整段一次计算的结果对照,并与 PyTorch 自带的 scaled_dot_product_attention(enable_gqa=True) 对照(d_model = 64,8 个查询头,2 组 K、V):
class GQA(nn.Module):
    def __init__(self, d_model, n_heads, n_kv_heads):
        super().__init__()
        self.h, self.hkv, self.dk = n_heads, n_kv_heads, d_model // n_heads
        self.wq = nn.Linear(d_model, n_heads * self.dk)
        self.wk = nn.Linear(d_model, n_kv_heads * self.dk)   # K、V 只有 n_kv_heads 组
        self.wv = nn.Linear(d_model, n_kv_heads * self.dk)
        self.out = nn.Linear(d_model, d_model)

    def forward(self, x, cache=None):                  # x: (B, t, d),解码时 t = 1
        B, t, d = x.shape
        q = self.wq(x).view(B, t, self.h, self.dk).transpose(1, 2)
        k = self.wk(x).view(B, t, self.hkv, self.dk).transpose(1, 2)
        v = self.wv(x).view(B, t, self.hkv, self.dk).transpose(1, 2)
        if cache is not None:                          # 新 Token 的 K、V 追加到缓存末尾
            if "k" in cache:
                k = torch.cat([cache["k"], k], dim=2); v = torch.cat([cache["v"], v], dim=2)
            cache["k"], cache["v"] = k, v              # 缓存的是 hkv 组,而不是 h 个头
        g = self.h // self.hkv                         # 每组 K、V 由 g 个查询头共用
        k, v = k.repeat_interleave(g, dim=1), v.repeat_interleave(g, dim=1)
        T = k.size(2)
        scores = q @ k.transpose(-2, -1) / self.dk ** 0.5             # (B, h, t, T)
        mask = torch.ones(t, T, dtype=torch.bool).triu(T - t + 1)     # 第 i 个新 Token 只看前 T-t+i+1 个
        o = scores.masked_fill(mask, float("-inf")).softmax(-1) @ v
        return self.out(o.transpose(1, 2).contiguous().view(B, t, d))

g = GQA(64, 8, 2)
x = torch.randn(1, 12, 64)
full = g(x)                                            # 整段一次计算(训练、预填充)
cache, steps = {}, []
p = g(x[:, :5], cache)                                 # 预填充前 5 个
for i in range(5, 12):                                 # 之后每次只输入 1 个新 Token
    steps.append(g(x[:, i:i + 1], cache))
inc = torch.cat([p] + steps, dim=1)
print("3. KV Cache 逐步解码与整段计算的最大误差:", (inc - full).abs().max().item())
print("   缓存的 K 形状:", tuple(cache["k"].shape), "(8 个查询头,只缓存 2 组)")
输出:
1. 与 nn.MultiheadAttention 的最大误差: 1.7881393432617188e-07
2. transpose 后 is_contiguous = False
   直接 view 报错: view size is not compatible with input tensor's size and stride (at least one dimension spans across two contiguous subspaces)
   reshape 等价于 contiguous().view,是否复制了数据: True
3. KV Cache 逐步解码与整段计算的最大误差: 1.862645149230957e-07
   缓存的 K 形状: (1, 2, 12, 8) (8 个查询头,只缓存 2 组)
   与 scaled_dot_product_attention(enable_gqa=True) 的最大误差: 1.4901161193847656e-07
torch 2.8.0
A2 在线 softmax 与注意力的计算量
环境:Python 3.13.7,numpy 2.3.3。按块读取 K、V,用在线 softmax 累积输出,与一次性计算的标准注意力对照(n = 1000,d = 64);再按 Qwen2.5-7B 的 config.json(hidden_size 3584,28 层,28 个查询头、4 组 K、V,intermediate_size 18944)计算分数矩阵的大小,以及每层线性层与注意力的计算量(不含偏置和归一化):
def online(q, K, V, block):
    m, l, o = -np.inf, 0.0, np.zeros(V.shape[1])     # 当前最大值、指数和、未归一化的输出
    for i in range(0, len(K), block):
        s = K[i:i + block] @ q / np.sqrt(len(q))       # 只算这一块的分数
        m_new = max(m, s.max())
        scale = np.exp(m - m_new)                       # 旧的累积量按新的最大值缩放
        p = np.exp(s - m_new)
        l = l * scale + p.sum()
        o = o * scale + p @ V[i:i + block]
        m = m_new
    return o / l
1. 块大小   1:与标准 softmax 注意力的最大误差 3.05e-16
1. 块大小  16:与标准 softmax 注意力的最大误差 1.11e-16
1. 块大小 128:与标准 softmax 注意力的最大误差 1.53e-16
2. 第 1 块后 m=2, l=1.368, o=17.358
   第 2 块:缩放系数 e^(2-3)=0.368, l=1.553, o=38.377, 输出 o/l=24.711
   一次 softmax:权重 [0.237 0.087 0.644 0.032], 输出 24.711
3. n = 4096:一个头的 n×n 分数矩阵(BF16)= 32 MiB,一层 28 个头 = 0.9 GiB
3. n = 32768:一个头的 n×n 分数矩阵(BF16)= 2048 MiB,一层 28 个头 = 56.0 GiB
   每层线性层参数 233.0M,每个 Token 的线性层计算量 2×233.0M = 466M FLOPs/层
   生成第 T 个 Token 时,注意力分数和加权求和的计算量 = 4 × T × 28×128 = 14336T FLOPs/层
   两者相等时 T = 32512
线性层每层的参数为 3584 × 3584 × 2(q_proj、o_proj)+ 3584 × 512 × 2(k_proj、v_proj)+ 3 × 3584 × 18944(前馈网络),每个参数做一次乘加计为 2 次浮点运算。
A3 ZeRO 的显存与 MLA 的 KV Cache
按 ZeRO 论文的记法,混合精度训练时每个参数的模型状态为 2 字节(BF16 参数)+ 2 字节(BF16 梯度)+ K 字节(FP32 参数副本和 Adam 的两个状态,K = 12),N 张卡时 ZeRO-1、ZeRO-2、ZeRO-3 每张卡分别为 4 + K / N、2 + (2 + K) / N、(4 + K) / N 字节。先用论文中的例子(7.5B,64 张卡)核对公式,再代入 Qwen2.5-7B(7,615,616,512 个参数)。MLA 按 DeepSeek-V3 的 config.json(kv_lora_rank 512,qk_rope_head_dim 64,qk_nope_head_dim 128,v_head_dim 128,128 个头,61 层)和 BF16 计算:
Qwen2.5-7B,8 张卡,只算模型状态(不含激活):
  不切分(普通数据并行)            每参数 16.00 字节,每张卡  121.8 GB
  ZeRO-1:切分优化器状态         每参数  5.50 字节,每张卡   41.9 GB
  ZeRO-2:再切分梯度           每参数  3.75 字节,每张卡   28.6 GB
  ZeRO-3:再切分参数           每参数  2.00 字节,每张卡   15.2 GB
  核对 ZeRO 论文 7.5B、64 卡: [120.0, 31.4, 16.6, 1.9]
DeepSeek-V3:61 层,128 个头,c_KV 512 维 + RoPE 键 64 维
  MLA 每个 Token:(512+64) × 61 × 2 字节 = 70272 字节 = 68.6 KB
  同样的头数和维度用 MHA:128 × (192+128) × 61 × 2 = 4.77 MB,是 MLA 的 71 倍
  对照 Qwen2.5-7B(GQA):56 KB
论文中的数值为 120 GB、31.4 GB、16.6 GB、1.9 GB,与上面的核对结果一致。
A4 RoPE 的相对位置与频率
环境:Apple M1 Pro,macOS 15.8.1,Python 3.13.7,NumPy 2.3.3。按 Qwen2.5-7B 的 config.json(每个头 128 维,rope_theta 1000000,max_position_embeddings 32768)实现 RoPE,128 维的 q、k 用随机数生成;三类的划分按 YaRN 论文的 α = 1、β = 32,扩展倍数取模型卡中的 4.0。下面只列出关键部分:
import numpy as np
d, base, L, s = 128, 1e6, 32768, 4.0
theta = base ** (-np.arange(0, d, 2) / d)          # 64 组的角速度
def rope(x, pos):
    x2 = x.reshape(-1, 2); c, sn = np.cos(pos * theta), np.sin(pos * theta)
    return np.stack([x2[:, 0] * c - x2[:, 1] * sn, x2[:, 0] * sn + x2[:, 1] * c], 1).reshape(-1)

wl = 2 * np.pi / theta; r = L / wl                 # 波长与训练长度内转的圈数
print((r < 1).sum(), (r > 32).sum())
print(0.1 * np.log(s) + 1)                         # YaRN 对 q、k 的缩放,分数为它的平方
输出:
不旋转 q·k = 0.346338
m=    5 n=    2 m-n=3  q_m·k_n = 3.115405
m=  103 n=  100 m-n=3  q_m·k_n = 3.115405
m=10003 n=10000 m-n=3  q_m·k_n = 3.115405
m=    5 n=    4 m-n=1  q_m·k_n = 1.079816
2D 30°: q@1=[0.866 0.5  ] k@0=[1. 0.] 点积=0.866
2D 30°: q@3=[0. 1.] k@2=[0.5   0.866] 点积=0.866
2D 30°: q@3=[0. 1.] k@0=[1. 0.] 点积=0.000
第 0 组 θ=1.0000 波长 6.28;第 63 组 θ=1.241e-06 波长 5063256
训练长度内转不满一圈 (r<1): 24 组;转 32 圈以上 (r>32): 24 组;介于之间: 16 组
最低频一组:位置 32767 转 0.041 rad,位置 131071 转 0.163 rad
PI 把位置除以 4:131071 → 32767.8
YaRN sqrt(1/t)=0.1 ln s + 1 = 1.1386,注意力分数放大 1.2965 倍
参考资料
- Attention Is All You Need
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Dao T. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. arXiv:2307.08691
- NVIDIA A100 Tensor Core GPU
- Su J, et al. RoFormer: Enhanced Transformer with Rotary Position Embedding. arXiv:2104.09864
- Chen S, et al. Extending Context Window of Large Language Models via Positional Interpolation. arXiv:2306.15595
- Peng B, et al. YaRN: Efficient Context Window Extension of Large Language Models. arXiv:2309.00071
- Qwen2.5-7B-Instruct 模型卡
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- Qwen2.5-7B-Instruct 模型配置
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434
- DeepSeek-V3 config.json
- Proximal Policy Optimization Algorithms
- Schulman J, et al. High-Dimensional Continuous Control Using Generalized Advantage Estimation. arXiv:1506.02438
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- Yu Q, et al. DAPO: An Open-Source LLM Reinforcement Learning System at Scale. arXiv:2503.14476
- Zheng C, et al. Group Sequence Policy Optimization. arXiv:2507.18071
- Liu Z, et al. Understanding R1-Zero-Like Training: A Critical Perspective. arXiv:2503.20783
- Qwen Team. Qwen3 Technical Report. arXiv:2505.09388
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models
- PyTorch FullyShardedDataParallel
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration