缓存
一、缓存特征
命中率
当某个请求能够通过访问缓存而得到响应时,称为缓存命中。
命中率指的是命中的请求占全部请求的比例,命中率越高,缓存的利用率也就越高。例如命中率从 90% 提高到 99%,未命中而到达数据库的请求从 10% 降为 1%,数据库的压力降为原来的 1/10。
最大空间
缓存通常位于内存中,内存的空间通常比磁盘空间小得多,因此缓存的最大空间不可能非常大。
当缓存存放的数据量超过最大空间时,就需要淘汰部分数据来存放新到达的数据。
淘汰策略
FIFO(First In First Out):先进先出策略,优先淘汰最早进入缓存的数据。实现简单,但是没有考虑数据的访问情况,命中率较低。
LRU(Least Recently Used):最近最久未使用策略,优先淘汰最久未使用的数据,也就是上次被访问时间距离现在最久的数据。该策略尽量把热点数据,也就是经常被访问的数据保留在内存中,从而保证缓存命中率。缺点是偶发的批量访问会把热点数据挤出缓存。
LFU(Least Frequently Used):最不经常使用策略,优先淘汰一段时间内使用次数最少的数据。缺点是过去的热点数据即使很久不再访问也难以被淘汰。
除了容量淘汰,缓存通常还会为数据设置过期时间,到期后自动失效。
二、缓存位置
浏览器
当 HTTP 响应允许进行缓存时,浏览器会将 HTML、CSS、JavaScript、图片等静态资源进行缓存。
ISP
网络服务提供商(ISP)是网络访问的第一跳,通过将数据缓存在 ISP 中能够大大提高用户的访问速度。
反向代理
反向代理位于服务器之前,请求与响应都需要经过反向代理。通过将数据缓存在反向代理,在用户请求反向代理时就可以直接使用缓存进行响应。
本地缓存
使用 Caffeine、Guava Cache 等把数据缓存在应用进程的内存中,读取时不经过网络,速度非常快。
分布式缓存
使用 Redis、Memcached 等单独部署的缓存服务,容量可以单独扩展,所有实例共享同一份数据;本地缓存则在每个实例中各存一份,数据更新后难以保持一致。
多级缓存
多级缓存把本地缓存和分布式缓存组合起来:先查本地缓存,未命中再查 Redis,再未命中才查数据库,并逐级回填。
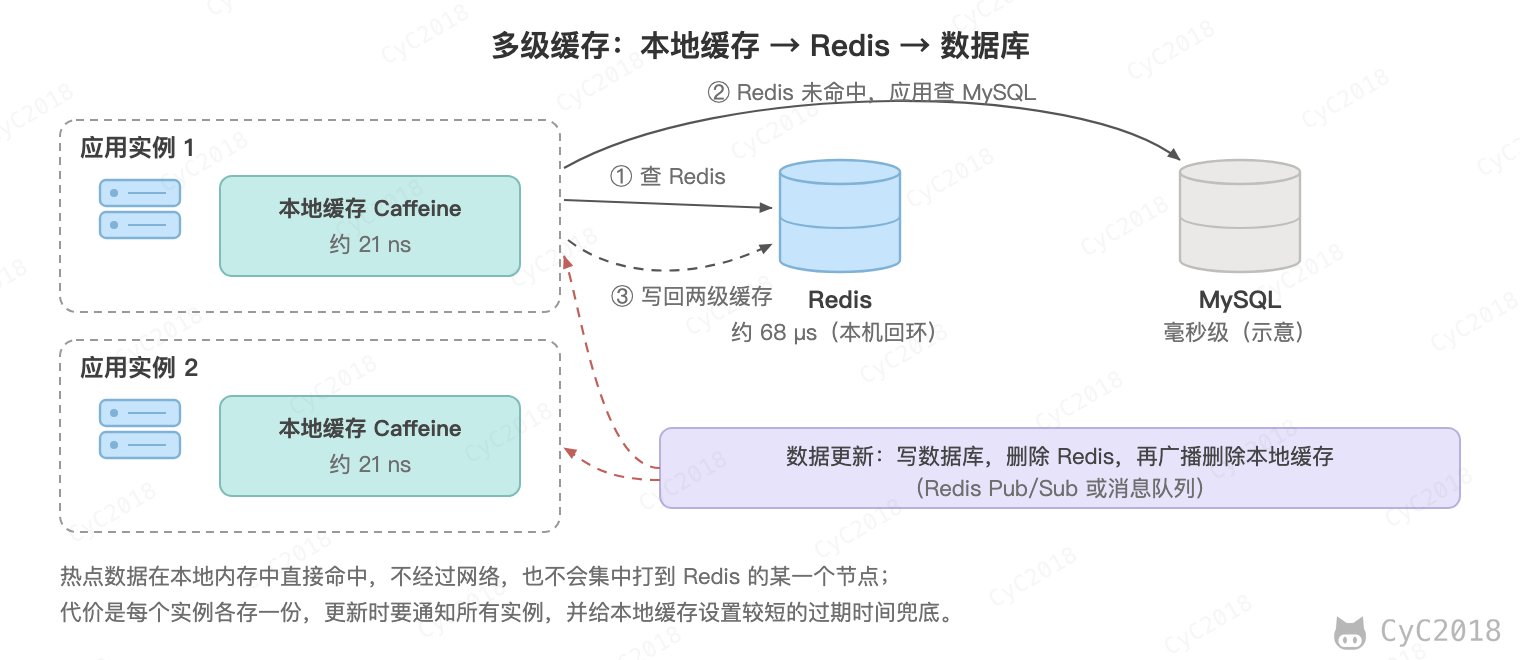
Caffeine 读取一次约 21 纳秒;用单个连接逐条向 Redis 发送 GET,每次约 68 微秒,相差三千多倍(JDK 21、Redis 7.4 实测,见附录 A1),这还只是客户端与 Redis 在同一台机器上的结果,跨机器访问还要加上网络往返。热点数据放在本地缓存中,既省去了网络开销,也不会让请求集中到存放这个热点键的 Redis 节点上。
难点在于数据更新后怎样让所有实例的本地缓存失效:
- 更新数据库后删除 Redis 中的键,再通过 Redis 的发布订阅或消息队列广播一条删除消息,各实例收到后删除自己的本地缓存。顺序不能反过来,否则本地缓存删除后、Redis 删除前的读请求会把 Redis 中的旧值重新加载到本地;
- Redis 的发布订阅不保证送达,实例断线期间的消息会丢失,所以本地缓存还要设置较短的过期时间(例如 30 秒)兜底,需要更可靠时改用消息队列。检测到订阅连接断开时清空本地缓存,并在订阅恢复前暂停使用和回填本地缓存;本地缓存从 Redis 回填时,过期时间取本地 TTL 与 Redis 中剩余 TTL 的较小值,避免本地副本比 Redis 中的值更晚过期;
- 因此本地缓存只适合读多写少、能接受短暂不一致的数据,例如商品详情、配置;库存、余额这类数据不要放在本地缓存中。
本地缓存不直接用 HashMap 或 ConcurrentHashMap,是因为它们没有容量上限和过期时间,JVM 内存会一直上涨。常用的是 Caffeine:
Cache<String, Product> cache = Caffeine.newBuilder()
        .maximumSize(10_000)                         // 最多 1 万个,超出时淘汰
        .expireAfterWrite(Duration.ofSeconds(30))    // 写入 30 秒后过期
        .build();

Product p = cache.get("product:1024", key -> loadFromRedisOrDb(key));
Caffeine 的淘汰算法 W-TinyLFU 同时考虑访问频率和最近访问时间:新数据先进入一个小的 LRU 窗口区,被窗口淘汰时再和主区将被淘汰的数据比较历史访问频率,频率高的留下,偶发的批量访问挤不掉热点数据,命中率通常高于 LRU。get 传入的加载函数对同一个键只会执行一次,其它并发的请求等待它的结果,避免缓存未命中时大量请求同时查询下游。加载函数抛出异常或返回 null 时不写入缓存,仍未命中的请求会再次执行它。通过 Spring 的 @Cacheable 使用时,默认不合并并发的未命中,要设置 sync = true 才走这个加载函数。
过期和刷新是两回事:expireAfterWrite 到期后,下一次读取要同步回源,请求会等待;refreshAfterWrite 要在构建时提供加载函数(build(loader) 得到 LoadingCache),到期后的第一次读取触发后台重新加载,刷新还没完成时返回旧值,同一个键在刷新期间不会重复发起刷新。两者常一起用,例如 1 分钟刷新、5 分钟过期,热点键一直由后台刷新,长时间没人访问的键最终过期,不会一直返回很旧的值(Caffeine 3.3 实测)。
maximumSize 限制的是条目数。值的大小相差很大时,例如商品详情从 0.1 KB 到 2 KB,同样 1 万个条目,值本身的大小就相差 20 倍。要按内存限制时改用 maximumWeight 加 weigher,由 weigher 返回每个条目估算的字节数。需要注意的是,权重只在写入或更新时计算一次,只用来判断是否超出上限,不影响淘汰哪一个条目,两种上限也不能同时设置。
数据库缓存
MySQL 等数据库管理系统具有自己的缓存机制来提高查询效率,例如 InnoDB 的 Buffer Pool 将数据页和索引页缓存在内存中。MySQL 的查询缓存因为命中率低、维护开销大,已经在 8.0 版本中被移除。
Java 内部的缓存
Java 为了优化空间,提高字符串、基本数据类型包装类的创建效率,设计了字符串常量池及 Byte、Short、Character、Integer、Long、Boolean 这六种包装类缓冲池。
CPU 多级缓存
CPU 为了解决运算速度与主存访问速度不匹配的问题,引入了多级缓存结构,同时使用 MESI 等缓存一致性协议来解决多核 CPU 缓存数据一致性的问题。
三、CDN
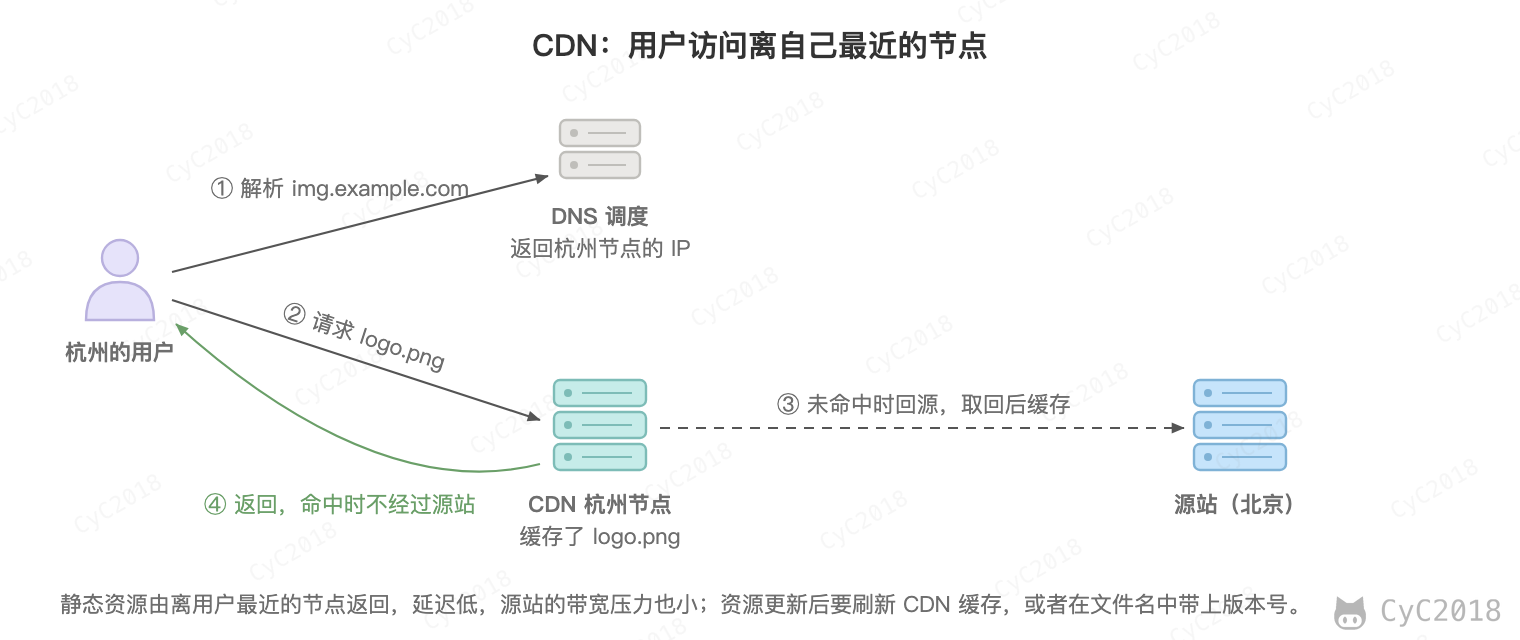
内容分发网络(Content Delivery Network, CDN)是一种互连的网络系统,它利用更靠近用户的服务器从而更快更可靠地将 HTML、CSS、JavaScript、音乐、图片、视频等静态资源分发给用户。
用户请求通过 DNS 被调度到最近的 CDN 节点,节点未命中缓存时再回源站获取。调度一般靠 CNAME:网站把域名用 CNAME 指向 CDN 提供的域名,由 CDN 的调度系统按查询来源的位置返回较近的节点,例子见 域名系统 中 www.jd.com 的解析结果。
CDN 主要有以下优点:
- 更快地将数据分发给用户;
- 通过部署多台服务器,从而提高系统整体的带宽性能;
- 多台服务器可以看成是一种冗余机制,从而具有高可用性。
静态资源更新后,节点上可能还缓存着旧版本。常用的做法是在文件名中带上版本或内容的哈希,例如 app.3f2a9c.js,并设置很长的缓存时间,内容一变文件名就变;入口的 HTML 用 no-cache,每次向源站确认,见 强缓存与协商缓存。也可以调用 CDN 的刷新接口让节点上的旧缓存失效,但一次刷新大量文件会让回源请求突然增多,AWS CloudFront 的文档也推荐用带版本号的文件名更新内容。
按用户生成的内容、带 Cache-Control: private 的响应和实时变化的接口不适合由 CDN 缓存。缓存键中包含查询参数时,与内容无关的参数(例如统计来源的 from=campaign)要去掉,否则同一个文件会被缓存成很多份,命中率下降。
四、缓存问题
穿透、击穿和雪崩都是请求越过缓存直接到达数据库,区别在于原因:穿透查询的是缓存和数据库中都不存在的数据,击穿是一个热点键过期,雪崩是大量的键同时过期或者缓存整体不可用。
缓存穿透
指的是对某个一定不存在的数据进行请求,该请求将会穿透缓存到达数据库。例如查询 id 为 -1 的商品,缓存里一直没有,每次请求都会查询数据库。
解决方案:
- 对这些不存在的数据缓存一个空数据,并设置较短的过期时间;
- 使用布隆过滤器保存所有存在的 Key,对不存在的 Key 的请求直接拒绝。
缓存空值只对重复出现的 Key 有效。攻击者每次随机生成不同的 ID 时,每个 ID 第一次都会查询数据库,缓存的空值再也用不上,还占用内存:10 万个空值键约占 15 MB(Redis 7.4 实测,见附录 A7)。另外,这个 ID 之后被新增时要删除缓存的空值,否则在空值过期之前一直查不到。随机生成的 ID 需要布隆过滤器来拦截。
布隆过滤器用多个哈希函数把 Key 映射到位数组的多个位置并置为 1。查询时只要有一个位置为 0,Key 就一定不存在;全部为 1 时 Key 可能存在,存在一定的误判率。所以判断不存在时直接返回空结果,可能存在时照常查询,误判只会多一次数据库查询。
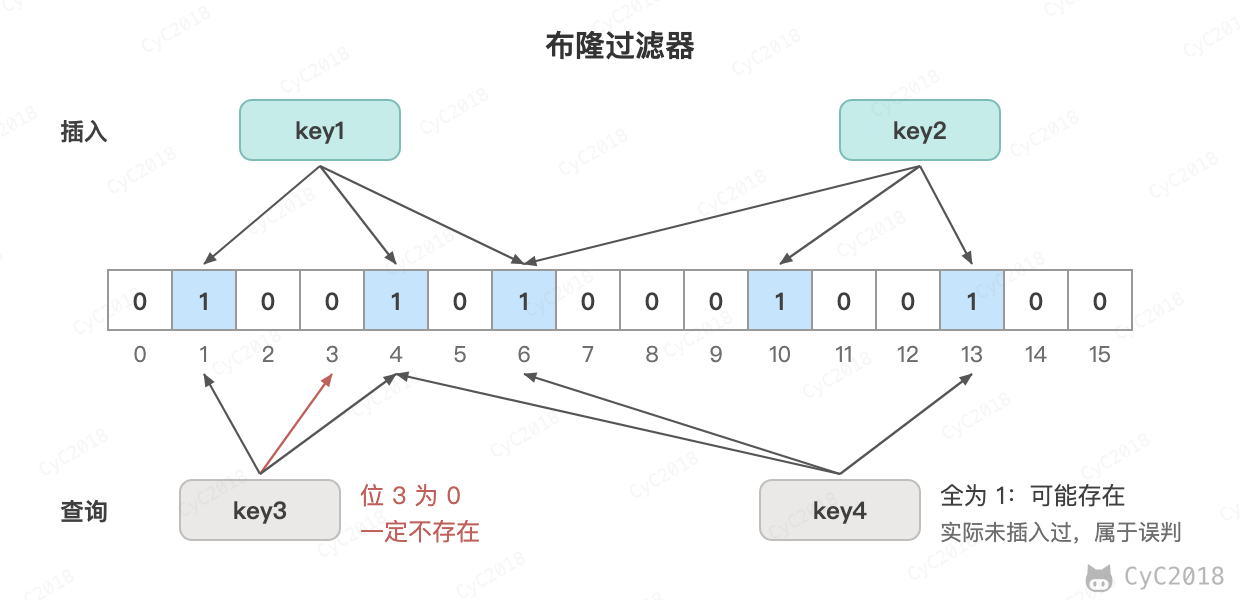
误判是因为这些位置可能都被其它 Key 置为 1。插入 n 个 Key、位数组为 m 位、使用 k 个哈希函数时,误判率约为 (1 - e-kn/m)k,k 取 (m/n) ln 2 时最小。每个 Key 占 10 位、k = 7 时,100 万个 Key 只需要 1.2 MB,按公式误判率为 0.82%;实际插入 100 万个 Key,再查询 100 万个不存在的 Key,误判率也是 0.82%(见附录 A6)。目标误判率为 1% 时,每个 Key 约需要 9.6 位,1 亿个 Key 约 114 MB。
使用时需要注意:
- 容量要预估准确:插入的 Key 超过预期后误判率迅速上升,例如按 100 万个 Key 配置的过滤器插入了 200 万个 Key,按公式误判率会升到约 14%。这是位数组大小固定(例如用 SETBIT 自己实现)的情况;Redis 的 BF.RESERVE 默认在容量用满后自动追加一层容量翻倍的子过滤器,并收紧各层的误判率,使总的误判率仍不超过设定值,代价是更多的内存和更慢的查询,加 NONSCALING 则用满后直接报错;
- 不能删除:一个位可能同时属于多个 Key,清零会让其它 Key 被误判为不存在,需要删除时可以定期用数据库中的全部 Key 重建(重建期间新增的 Key 同时写入新旧过滤器,建完再切换),或者使用计数布隆过滤器(每一位换成计数器,删除时减 1)、布谷鸟过滤器,它们也只能删除确实插入过、尚未删除的 Key;
- 新增的数据要同时写入布隆过滤器,否则请求会被误判为不存在而拒绝。先写过滤器再写数据库:数据库写入失败只是多一个误判,反过来过滤器写入失败,这条数据会一直被拒绝。
Redis 8 起内置了布隆过滤器(BF.RESERVE、BF.ADD、BF.EXISTS),Redis 7 需要加载 RedisBloom 模块。用 BF.RESERVE key 误判率 容量 预先创建,例如 BF.RESERVE product:bf 0.01 100000000;不先创建就执行 BF.ADD 时,会按默认的容量 100、误判率 1% 自动创建一个,之后频繁扩展。
实际使用时通常把几种做法组合起来:先在接口层校验参数,格式不对或者超出已分配范围的 ID 直接拒绝;再用布隆过滤器拦截不存在的 Key;少量误判漏过的请求用空值缓存兜底;同一来源大量查询不存在的数据时进行限流。
缓存击穿
指的是某个热点数据的缓存过期时,大量对它的请求同时到达数据库。
解决方案:
- 互斥锁:缓存未命中时用
SET lock:product:1024 <随机值> NX EX 3抢锁,抢到的请求先再查一次缓存(可能别人已经写回),仍然没有才查询数据库并写回缓存,最后释放锁(释放时要确认锁仍是自己的,见 分布式锁);没抢到的请求等待一小段时间(例如 10 毫秒)后重新读缓存,等待的总时长要有上限,超过后返回默认值或报错,否则持锁的请求崩溃时,其它请求要一直等到锁过期。锁的过期时间要长于重建缓存的耗时,否则锁会在重建期间过期,其它请求再次抢到锁并回源,例如锁 100 毫秒、重建 300 毫秒时,100 个并发请求回源 4 次(见附录 A5);耗时难以估计时可以给锁续期,见分布式锁; - 逻辑过期:键不设置过期时间,而是在值中保存一个过期时间。读到已经过期的值时,抢到锁的请求启动后台线程重建缓存,所有请求都直接返回旧值,不等待。这些键不会被 volatile 开头的淘汰策略淘汰,不再需要时要主动删除。
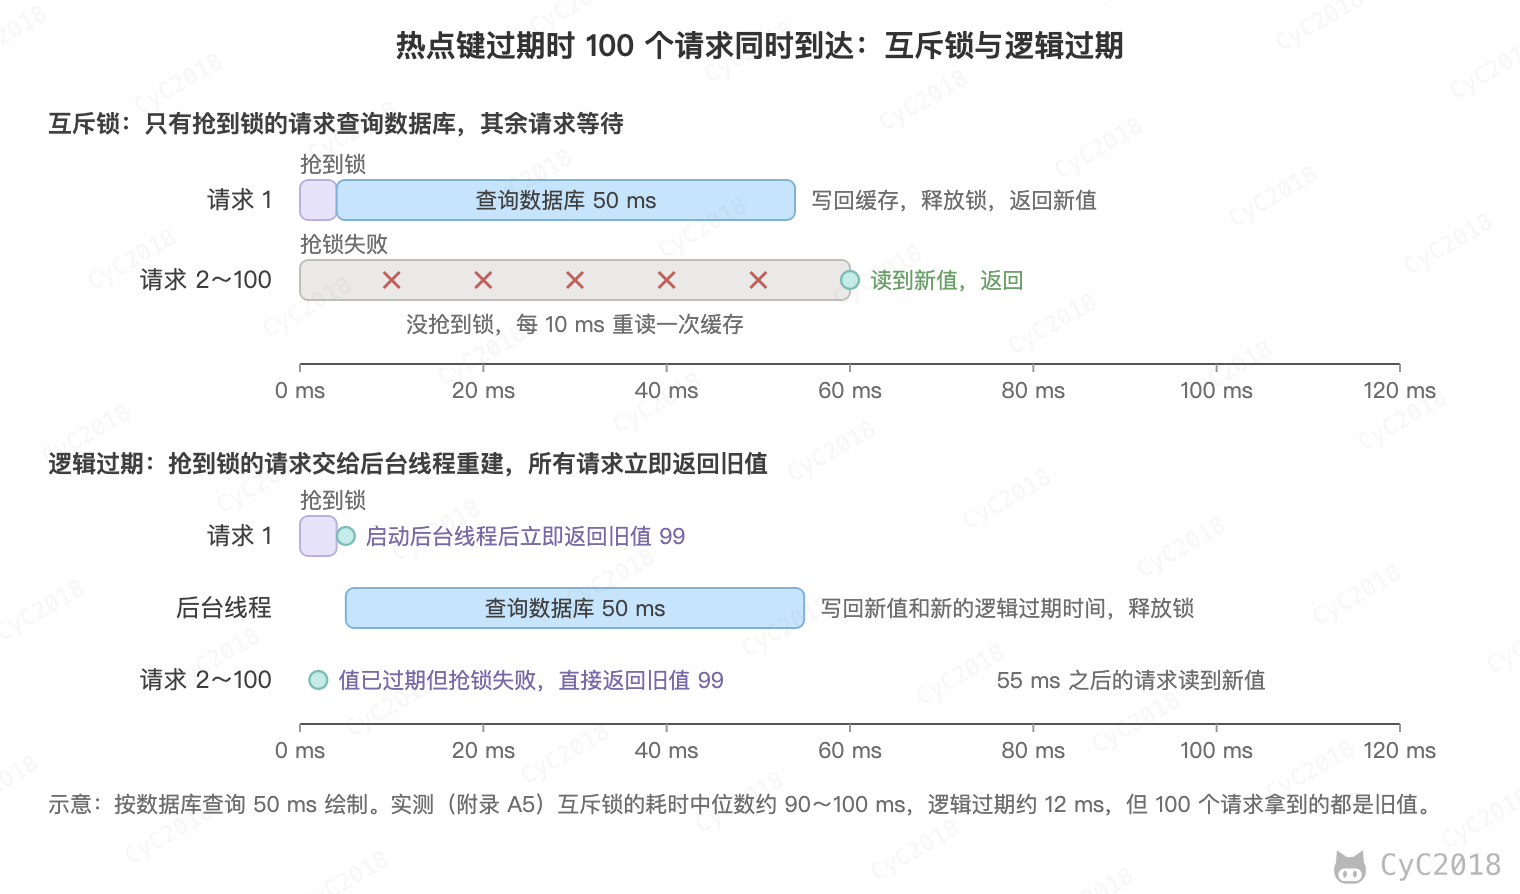
两者都只让一个请求查询数据库,区别在于等待重建还是返回旧值。热点键刚过期时 100 个请求同时到达,数据库查询耗时 50 毫秒:不加保护时查询了数据库 68~100 次;互斥锁只查询 1 次,请求耗时的中位数约 90~100 毫秒;逻辑过期也只查询 1 次,耗时中位数约 12 毫秒,但 100 个请求拿到的都是旧值(Redis 7.4、MySQL 8.0 实测,见附录 A5)。要求数据准确时用互斥锁,能接受短暂的旧值、更看重响应时间时用逻辑过期。
写请求按 Cache Aside 删除热点键后同样会击穿。用逻辑过期时,写请求不删除键,而是把值中的过期时间改为已过期,由后台重建。
缓存雪崩
指的是由于数据没有被加载到缓存中,或者缓存数据在同一时间大面积失效(过期),又或者缓存服务器宕机,导致大量的请求都到达数据库。
缓存平时分担了绝大部分的读请求,数据库只按剩下的流量配置。例如命中率为 99% 时,每秒 1 万次读请求中只有 100 次到达数据库;缓存整体失效后这 1 万次都到达数据库,压力变为原来的 100 倍,数据库可能因此崩溃。
解决方案:
- 为了防止缓存在同一时间大面积过期导致的缓存雪崩,可以在过期时间上加一个随机值,让过期时间分散开,例如活动开始时一起写入的 10 万个商品,过期时间从统一的 3600 秒改为 3600~3900 秒中的随机值;
- 为了防止缓存服务器宕机出现的缓存雪崩,可以使用分布式缓存,每一个节点只缓存部分的数据;每个节点还要配上从节点,由哨兵或 Redis Cluster 自动故障转移;
- 也可以进行缓存预热,避免在系统刚启动不久由于还未将大量数据进行缓存而导致缓存雪崩;
- 在应用中加一层本地缓存,Redis 不可用时热点数据仍能命中,见 多级缓存;
- 对数据库的访问进行限流,即使缓存失效也不至于压垮数据库;Redis 大面积超时时熔断,直接返回默认值或者提示稍后重试,见 限流、降级与熔断。
缓存一致性
缓存一致性(也常称为双写一致性)要求数据更新之后缓存中不能长期保留旧数据。常用的是 Cache Aside 模式:
- 读:先读缓存,未命中则读数据库,并将结果写入缓存;
- 写:先更新数据库,再删除缓存。
删除缓存而不是更新缓存,原因有两个:
- 并发的写操作到达缓存的顺序可能和到达数据库的顺序不同:例如写请求 A 把价格改为 10、写请求 B 改为 20,数据库中 A 先执行、B 后执行,结果为 20,更新缓存时却是 B 先到、A 后到,缓存中留下的是 10;
- 写多读少的数据每次写入都更新缓存,值可能还没被读取就又被覆盖。
先更新数据库再删除缓存,是因为反过来的话,删除缓存之后、更新数据库之前的读请求会把旧值重新写入缓存:
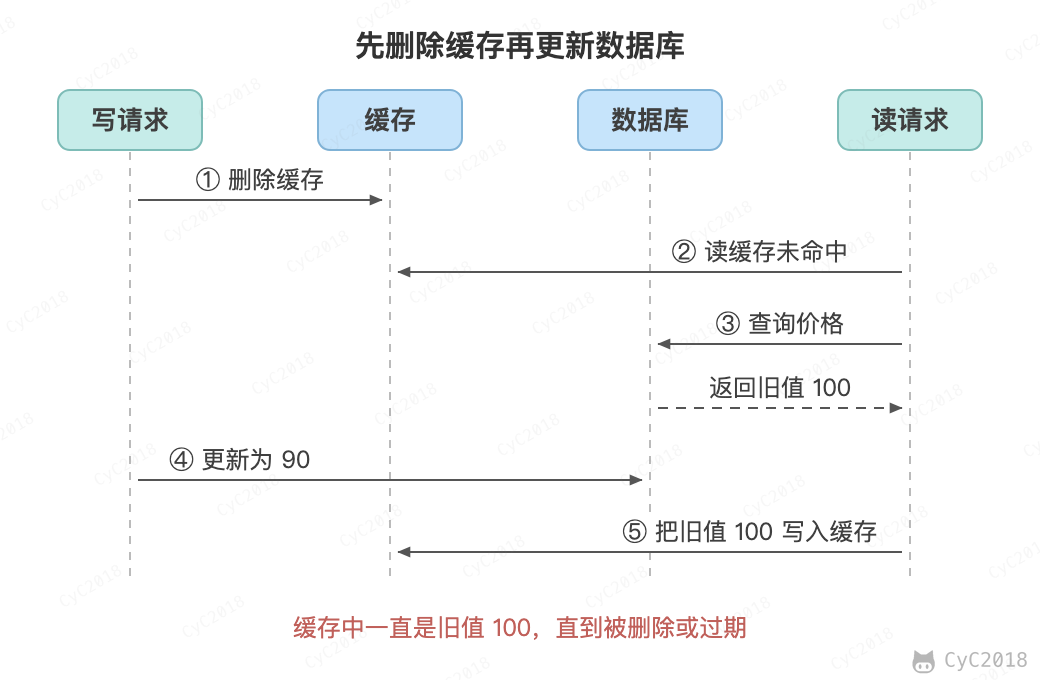
需要注意的是,“更新数据库”指事务已经提交,否则提交之前的读请求仍会把旧值写回缓存;用 Spring 的 @Transactional 时,删除缓存要放到提交之后,例如 @TransactionalEventListener 默认的 AFTER_COMMIT 阶段。
先更新数据库再删除缓存,仍然有两种情况会留下旧值:
- 删除缓存失败,例如 Redis 超时;
- 缓存刚好过期时,读请求从数据库读到旧值后停顿了一段时间(例如 GC),在它写回缓存之前,写请求更新了数据库并删除了缓存,之后读请求把旧值写入缓存。
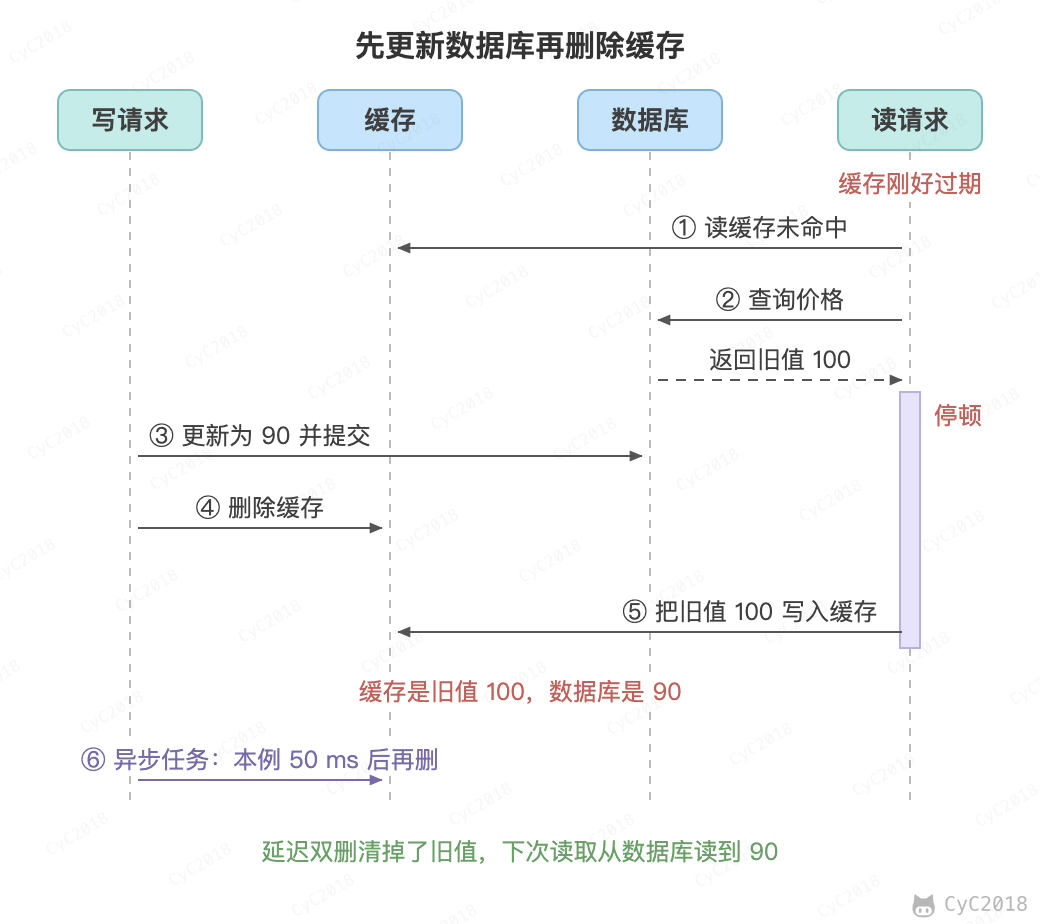
第二种情况要求缓存恰好失效,并且读请求从查询数据库到写回缓存的耗时比写请求更新数据库再删除缓存还长,因此概率很小。
用 8 个读进程不停读取同一个键,写入 1000 次:先删缓存再更新数据库有 980 次留下了旧值,先更新数据库再删缓存为 0 次。让缓存在每次写入前过期、读请求写回缓存前随机停顿 0~5 毫秒之后,先更新数据库再删缓存也有 542 次留下了旧值,加上延迟双删后为 0 次(MySQL 8.0、Redis 7.4 实测,见附录 A4)。
常用的补救措施:
- 为缓存设置过期时间作为兜底,需要注意过期时间从这次写回缓存时算起,慢读请求很晚才写回旧值时,旧值最长还会保留一个完整的过期时间;
- 延迟双删:更新数据库并删除缓存之后,隔一段时间再删除一次,清掉慢读请求写回的旧值;
- 删除失败时重试:把要删除的键发到消息队列,由消费者删除,失败就重新投递;
- 订阅 binlog 删除缓存:Canal 这类组件伪装成 MySQL 的从库读取 binlog,发现某一行被修改就删除对应的缓存键,失败时重试,业务代码中不再需要删除缓存,手工执行的 SQL 也能覆盖,代价是多部署一套组件,而且和直接删除一样挡不住在删除之后才写回的旧值;
- 写回缓存时检查期间是否有过删除:Facebook 的 Memcache 在缓存未命中时发给读请求一个租约(lease)令牌,写回时要带上令牌,如果这期间键被删除,令牌就会失效,旧值写不进缓存。
延迟双删的第二次删除不能让写请求同步等待,通常交给线程池或者延迟消息执行。间隔要大于读请求从查询数据库到写回缓存的耗时,读请求走从库时还要加上主从复制的延迟:附录 A4 中读请求最多停顿 5 毫秒,间隔取 50 毫秒时没有留下旧值;间隔太短清不掉旧值,太长则旧值在缓存中停留更久。第二次删除也可能失败,同样要重试,最后靠过期时间兜底。
常见的组合是先更新数据库再删除缓存,删除失败时重试,再用过期时间兜底。读主库时,延迟双删针对的情况概率很小,还会让热点键多一次未命中,对一致性要求较高时再加。
读写分离时,主库提交并删除缓存后从库可能还没有这次更新,未命中的读请求会把从库中的旧值写回缓存。这种情况不需要读请求很慢,只要它在复制延迟期间读从库就会发生。可以在写入后的一小段时间内让这个键的读请求查主库,或者订阅从库的 binlog 删除缓存;延迟双删也可以,间隔要求见上文。上面的租约挡不住这种情况,因为读请求是在删除之后才拿到令牌的。
缓存和数据库之间只能做到最终一致,要保证强一致需要付出很大的代价,例如读写都加分布式读写锁,写入期间所有读请求等待。缓存数据最好是那些对一致性要求不高、能接受短时间读到旧值的数据,余额、库存扣减这类数据应该直接读写数据库。秒杀中先在 Redis 中扣减库存、再异步写数据库的做法不属于这里的缓存,Redis 中的库存不能删除后从数据库重新加载,见 Redis 与数据库的库存一致。
缓存 “无底洞” 现象
指的是为了满足业务要求添加了大量缓存节点,但是性能不但没有好转反而下降了的现象。
产生原因:缓存系统通常采用哈希函数将键映射到对应的缓存节点,随着缓存节点数目的增加,键值分布到更多的节点上,导致客户端一次批量操作会涉及多次网络操作,这意味着批量操作的耗时会随着节点数目的增加而不断增大。此外,网络连接数变多,对节点的性能也有一定影响。
解决方案:
- 按节点分组:客户端先算出每个键所在的节点,同一个节点的键用流水线一次发送,网络往返次数从键的数量降为节点的数量(Redis Cluster 中一条 MGET 的键必须在同一个槽,所以用流水线);
- 并行发送:各节点的请求同时发出,耗时取决于最慢的节点;
- 哈希标签:经常一起读取的键用 {} 放到 Redis Cluster 的同一个槽中,一次请求取回;
- 使用长连接、连接池,减少建立连接的开销。
大 Key 与热 Key
大 Key 指的是值很大的键,例如几 MB 的字符串,或者包含几十万个元素的集合;热 Key 指的是访问量远高于其它键的键,例如秒杀商品的库存。
大 Key 的问题:
- 阻塞:Redis 用一个线程执行命令,对大 Key 执行 HGETALL、DEL 这类 O(N) 的命令时,其它命令都要等待。删除一个有 100 万个字段、占用 64 MB 内存的 HASH,DEL 耗时约 345 ms,而 UNLINK 只需几微秒,它在后台线程中释放内存(Redis 7.4 实测,见附录 A2);
- 网络:一次读写的数据量大,占用带宽;
- 数据倾斜:在集群中,大 Key 所在节点的内存和流量都会高于其它节点;
- 过期和淘汰:大 Key 过期或被淘汰时,默认也由主线程释放内存。一个 100 万字段的 HASH 过期时,主线程停顿约 400 ms;开启 lazyfree-lazy-expire 后交给后台线程释放,期间最慢的 PING 只有 3.6 ms(Redis 7.4 实测,见附录 A8)。
大 Key 的发现与处理:
- 用 redis-cli --bigkeys 或者 --memkeys 扫描,它们使用 SCAN 命令遍历,不会阻塞服务器;用 MEMORY USAGE 查看单个键占用的内存;
- 拆分:例如把一个大的 HASH 按字段的哈希值拆成 16 个小 HASH,user:1001:fav:0 到 user:1001:fav:15,读写字段 f 时访问第 hash(f) % 16 个;大的字符串可以压缩,或者把文件放到对象存储,Redis 中只保存地址;
- 删除用 UNLINK,并开启 lazyfree-lazy-expire、lazyfree-lazy-eviction 和 lazyfree-lazy-server-del,让过期、淘汰以及 SET、RENAME 覆盖旧值时的删除也在后台释放内存;读取集合时用 HSCAN、SSCAN 分批读取,不要一次读出所有元素。
热 Key 的问题是请求集中到同一个节点,集群中其它节点再多也无法分担。处理方法:
- 发现:redis-cli --hotkeys,它读取的是 LFU 的访问计数,要求淘汰策略为 LFU,见 七、数据淘汰策略。这个计数按概率对数增长,默认配置下连续访问 10 万次约为 148,100 万次就到上限 255(Redis 7.4 实测,每次结果略有波动);停止访问后每分钟减 1。它反映的是带衰减的累计热度,分不出两个都已饱和的键,也不能可靠地判断哪个键刚刚变热。实时发现要在客户端或者代理中按时间窗口计数,例如 2 秒内访问超过 10 次;
- 本地缓存:在应用中缓存热 Key 的值,大部分请求不再访问 Redis,代价是数据会有短暂的不一致,见上文的 本地缓存。热 Key 事先不知道时,可以由探测服务汇总各实例上报的访问次数,判定为热点后把键名推送给所有实例,实例只为名单中的键开启本地缓存,并按规则设置过期时间,例如京东开源的 hotkey;
- 复制多份:把同一个值写到 product:1024#0 到 product:1024#9 这 10 个键中,读取时随机选一个。这些键分布在不同的槽上,请求就分散到了多个节点,代价是写入时要更新所有副本,只适合读多写少的数据;
- 写热点:上面两种做法只分担读请求。库存可以拆成几份放在不同的键中分别扣减,见秒杀系统;点赞数这类计数可以先在应用内累加,每隔一秒用一次 INCRBY 写入,见热门视频的计数。
热 Key 过期时大量请求同时打到数据库的问题,见上文的缓存击穿。
五、数据分布
哈希分布
哈希分布就是将数据计算哈希值之后,按照哈希值分配到不同的节点上。例如有 N 个节点,数据的主键为 key,则将该数据分配的节点序号为:hash(key)%N。
传统的哈希分布算法存在一个问题:当节点数量变化时,也就是 N 值变化,那么几乎所有的数据都需要重新分布,将导致大量的数据迁移。例如节点从 4 个增加到 5 个时,只有 hash(key) % 4 与 hash(key) % 5 相等的键可以留在原节点,约 80% 的键都要迁移(见附录 A3)。另外哈希打乱了数据的顺序,不能高效地进行范围查询。
顺序分布
将数据划分为多个连续的部分,按数据的 ID 或者时间分布到不同节点上。例如 User 表的 ID 范围为 1 ~ 7000,使用顺序分布可以将其划分成多个子表,对应的主键范围为 1 ~ 1000,1001 ~ 2000,...,6001 ~ 7000。
顺序分布相比于哈希分布的主要优点如下:
- 能保持数据原有的顺序;
- 能够准确控制每台服务器存储的数据量,从而使得存储空间的利用率最大。
缺点是容易产生热点,例如按时间分布时,写入都集中在最新的节点上。
六、一致性哈希
一致性哈希(Consistent Hashing)是一种哈希分布方式,其目的是为了克服传统哈希分布在服务器节点数量变化时大量数据迁移的问题。这里的“一致性”和副本一致性、ACID 一致性没有关系,只是指节点变化时键尽量留在原来的节点上。
基本原理
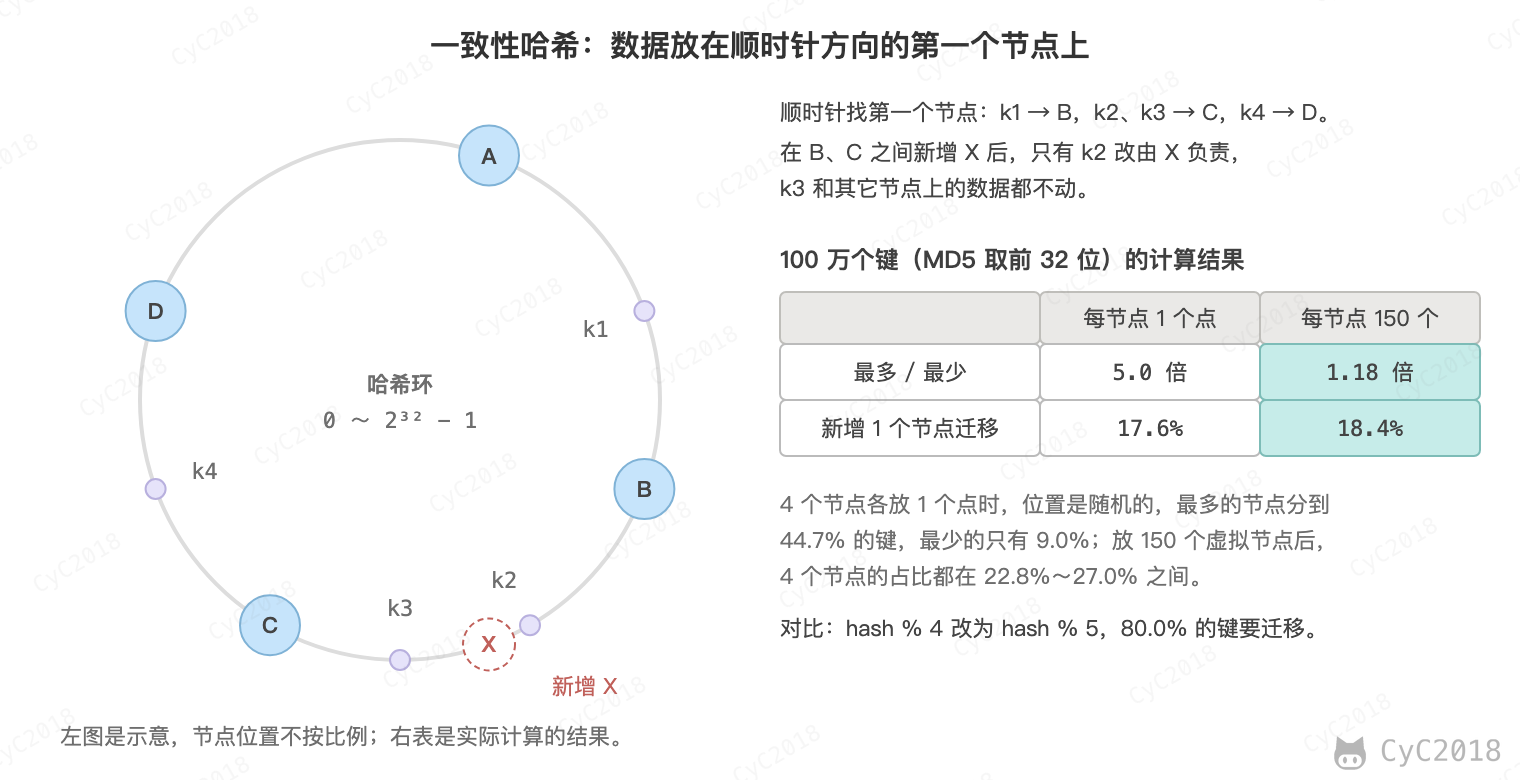
将哈希空间 [0, 2n-1] 看成一个哈希环,每个服务器节点都通过哈希配置到哈希环上。每个数据对象通过哈希函数得到哈希值之后,存放到哈希环中顺时针方向第一个大于等于该哈希值的节点上。
一致性哈希在增加或者删除节点时只会影响到哈希环中相邻的节点,例如下图中在 B 和 C 之间新增节点 X,只需要将节点 C 上哈希值位于 B 和 X 之间的数据迁移到 X 上即可,对于节点 A、B、D 都没有影响。同样从 4 个节点增加到 5 个,理论上约 1/5 的键需要迁移,100 万个键实测为约 18%。
虚拟节点
上面描述的一致性哈希存在数据分布不均匀的问题,节点存储的数据量有可能会存在很大的不同。
数据不均匀主要是因为节点在哈希环上分布的不均匀,这种情况在节点数量很少的情况下尤其明显。例如 4 个节点各在环上放 1 个位置时,100 万个键中最多的节点分到 44.7%,最少的只有 9.0%。
解决方式是通过增加虚拟节点,然后将虚拟节点映射到真实节点上。虚拟节点的数量比真实节点来得多,那么虚拟节点在哈希环上分布的均匀性就会比原来的真实节点好,从而使得数据分布也更加均匀。每个节点放 150 个虚拟节点后,4 个节点的占比在 22.8%~27.0% 之间。
Redis Cluster 使用的不是一致性哈希,而是把 Key 映射到固定的 16384 个哈希槽上,再把哈希槽分配给各个节点,节点变化时只需要迁移对应的哈希槽,见 Redis Cluster。好处是迁移可控:新增节点时可以指定从每个旧节点迁走多少个槽,一致性哈希中新节点分走哪一段由它的哈希值决定。
七、LRU
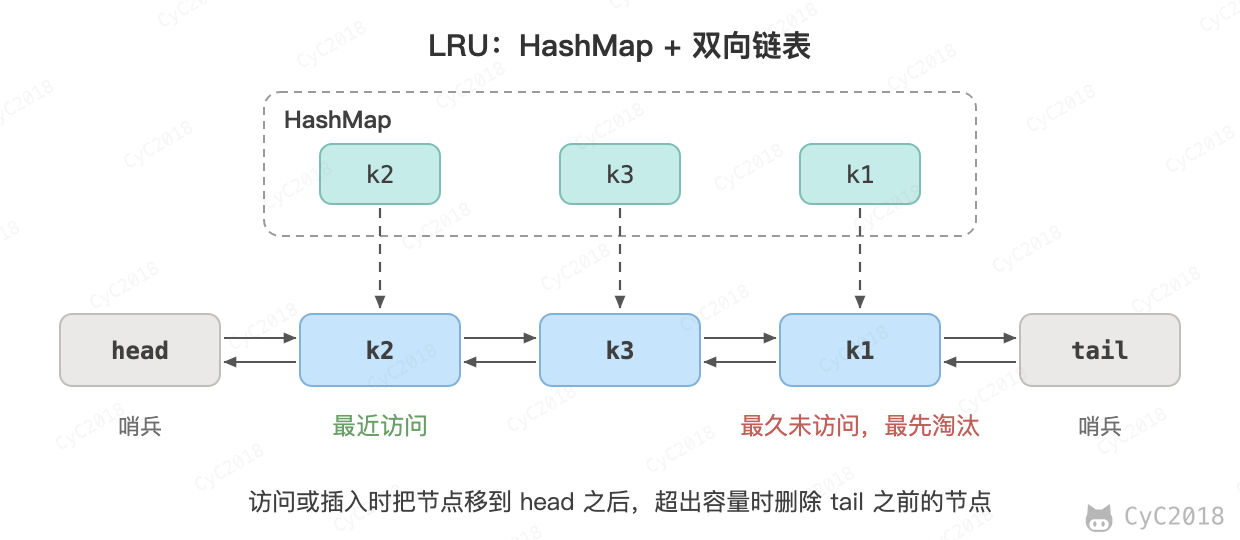
以下是基于双向链表和 HashMap 的 LRU 算法实现,对算法的解释如下:
- 访问某个节点时,将其从原来的位置删除,并重新插入到链表头部。这样就能保证链表尾部存储的就是最近最久未使用的节点,当节点数量大于缓存最大空间时就淘汰链表尾部的节点;
- 为了使删除操作时间复杂度为 O(1),就不能采用遍历的方式找到某个节点。HashMap 存储着 Key 到节点的映射,通过 Key 就能以 O(1) 的时间得到节点,然后再以 O(1) 的时间将其从双向链表中删除;
- 用双向链表是因为删除节点时要修改前一个节点的指针,单向链表只能从头遍历才能找到它;节点中还要保存 Key,淘汰尾部节点时才能用它删除 HashMap 中对应的项。
Java 的 LinkedHashMap 内部就是这种结构,把 accessOrder 设为 true 并重写 removeEldestEntry 方法,就可以直接得到一个 LRU 缓存:
public class LRUCache<K, V> extends LinkedHashMap<K, V> {

    private final int maxSize;

    public LRUCache(int maxSize) {
        super(16, 0.75f, true);    // 第三个参数 accessOrder 为 true:按访问顺序排列
        this.maxSize = maxSize;
    }

    @Override
    protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
        return size() > maxSize;   // 插入新键之后调用,返回 true 时删除最久未访问的元素
    }
}
例如容量为 2 时依次 put(1)、put(2)、get(1)、put(3),被淘汰的是 2。LinkedHashMap 把最近访问的放在尾部,与下面手写实现的方向相反。面试中手写 LRU 时通常要求不用 LinkedHashMap,自己实现链表:
public class LRU<K, V> implements Iterable<K> {

    private Node head;
    private Node tail;
    private HashMap<K, Node> map;
    private int maxSize;

    private class Node {

        Node pre;
        Node next;
        K k;
        V v;

        public Node(K k, V v) {
            this.k = k;
            this.v = v;
        }
    }


    public LRU(int maxSize) {

        this.maxSize = maxSize;
        this.map = new HashMap<>(maxSize * 4 / 3);

        head = new Node(null, null);
        tail = new Node(null, null);

        head.next = tail;
        tail.pre = head;
    }


    public V get(K key) {

        if (!map.containsKey(key)) {
            return null;
        }

        Node node = map.get(key);
        unlink(node);
        appendHead(node);

        return node.v;
    }


    public void put(K key, V value) {

        if (map.containsKey(key)) {
            Node node = map.get(key);
            unlink(node);
        }

        Node node = new Node(key, value);
        map.put(key, node);
        appendHead(node);

        if (map.size() > maxSize) {
            Node toRemove = removeTail();
            map.remove(toRemove.k);
        }
    }


    private void unlink(Node node) {

        Node pre = node.pre;
        Node next = node.next;

        pre.next = next;
        next.pre = pre;

        node.pre = null;
        node.next = null;
    }


    private void appendHead(Node node) {
        Node next = head.next;
        node.next = next;
        next.pre = node;
        node.pre = head;
        head.next = node;
    }


    private Node removeTail() {

        Node node = tail.pre;

        Node pre = node.pre;
        tail.pre = pre;
        pre.next = tail;

        node.pre = null;
        node.next = null;

        return node;
    }


    @Override
    public Iterator<K> iterator() {

        return new Iterator<K>() {
            private Node cur = head.next;

            @Override
            public boolean hasNext() {
                return cur != tail;
            }

            @Override
            public K next() {
                Node node = cur;
                cur = cur.next;
                return node.k;
            }
        };
    }
}
上面的实现不是线程安全的:get() 也会移动链表中的节点,多个线程同时访问会破坏链表,所以读操作也要加锁。简单的做法是 get() 和 put() 使用同一把锁,或者用 Collections.synchronizedMap() 包装上面的 LinkedHashMap。需要注意的是,不能用读写锁的读锁保护 get():8 个线程并发访问时没有抛出异常,但链表已被破坏,size() 为 1999,遍历只能走到 1 个节点(JDK 21 实测,见附录 A9)。
并发高时有两种做法:一是分段,按 Key 的哈希分到 16 个各自加锁的 LRU,代价是只在段内淘汰;二是用 Caffeine,它不在每次读取时调整顺序,而是把访问记录写入缓冲区,再批量调整,读操作不需要获取全局锁。
LRU 只看最近一次访问,一次全表扫描读入的冷数据就会把热点挤出去。MySQL 的 Buffer Pool 因此把链表分为 young 和 old 两段:新读入的页先放在 old 段,距首次访问超过 innodb_old_blocks_time(默认 1000 ms)后再被访问才移到 young 段,全表扫描读入的页很快就被淘汰。Redis 则不维护链表,随机抽样近似 LRU,见 七、数据淘汰策略。
附录:实测
以下实验的环境均为 Apple M1 Pro(10 核)、macOS,Redis 7.4.1 使用默认配置,客户端和服务器在同一台机器上。
A1 本地缓存与 Redis 的读取耗时
Caffeine 3.1.8,JDK 21。缓存中放入 1000 个键,每轮执行 1000 万次 getIfPresent,前几轮用于 JIT 预热:
Cache<String, String> cache = Caffeine.newBuilder()
        .maximumSize(10_000)
        .expireAfterWrite(Duration.ofSeconds(30))
        .build();
for (int i = 0; i < 1000; i++) cache.put("product:" + i, "{\"id\":" + i + ",\"price\":99}");
for (int r = 0; r < 5; r++) {
    long t0 = System.nanoTime();
    for (int i = 0; i < 10_000_000; i++) sink += cache.getIfPresent(keys[i % 1000]).length();
    System.out.printf("round %d: %.1f ns/get%n", r, (System.nanoTime() - t0) / 1e7);
}
Redis 用一个连接逐条发送 10 万次 GET:
redis-benchmark -c 1 -n 100000 -t get -q
round 0: 22.5 ns/get
round 1: 21.1 ns/get
round 2: 20.7 ns/get
round 3: 20.7 ns/get
round 4: 20.7 ns/get
GET: 14626.30 requests per second, p50=0.063 msec
每秒 14626 次,平均每次约 68 微秒。
A2 删除大 Key
用流水线向 user:1001:fav 写入 100 万个字段,分别用 DEL 和 UNLINK 删除,执行前设置 CONFIG SET slowlog-log-slower-than 0,从 SLOWLOG 读取服务器的执行时间:
> HLEN user:1001:fav
1000000
> MEMORY USAGE user:1001:fav
64388720
> DEL user:1001:fav
1
SLOWLOG: 345637 微秒 DEL
(重新写入 100 万个字段)
> UNLINK user:1001:fav
1
SLOWLOG: 8 微秒 UNLINK
A3 哈希分布与一致性哈希
100 万个键 user:0~user:999999,哈希值取 MD5 的前 4 个字节,哈希环的范围为 [0, 232-1]。节点 A~E 在环上的位置为节点名的哈希值,虚拟节点为 A#0~A#149 这样的名字的哈希值,键存放在顺时针方向第一个大于等于它的位置对应的节点上:
def h(s):
    return int.from_bytes(hashlib.md5(s.encode()).digest()[:4], "big")

keys = [h(f"user:{i}") for i in range(1_000_000)]
moved = sum(1 for k in keys if k % 4 != k % 5)

def ring(nodes, vnodes):
    pts = sorted((h(f"{n}#{v}" if vnodes > 1 else n), n) for n in nodes for v in range(vnodes))
    return [p for p, _ in pts], [n for _, n in pts]

def owner(r, k):
    pos, names = r
    i = bisect.bisect_left(pos, k)
    return names[i % len(names)]
取模:4 个节点增加到 5 个,迁移 80.0% 的键
一致性哈希,每个节点 1 个位置:4 个节点的占比 A 44.7%、B 11.6%、C 9.0%、D 34.6%;增加节点 E 后迁移 17.6% 的键
一致性哈希,每个节点 150 个位置:4 个节点的占比 A 27.0%、B 26.1%、C 24.1%、D 22.8%;增加节点 E 后迁移 18.4% 的键
A4 缓存一致性的三种写法
MySQL 8.0.44,Redis 7.4.1,Python 3.13(pymysql、redis-py)。表中只有一行价格,8 个读进程不停读取:缓存未命中时查询数据库并写回缓存。写入方每次把价格加 1,按三种写法之一处理缓存,延迟双删的间隔为 50 毫秒;每次写入后等在途的读请求结束,检查缓存中是否留下了旧值,留下则计数并删除:
def reader(flag):
    while not flag.value:
        if r.get(KEY) is None:
            c.execute('select price from cache_demo where id = 1')
            v = c.fetchone()[0]
            if READ_DELAY:
                time.sleep(random.uniform(0, READ_DELAY))
            r.set(KEY, v)

# 写入方,第 i 次写入
if EXPIRE:
    r.delete(KEY)                                    # 模拟缓存刚好过期
if strategy == 'delete-then-update':
    r.delete(KEY); c.execute('update cache_demo set price = %s where id = 1', (i,))
else:
    c.execute('update cache_demo set price = %s where id = 1', (i,)); r.delete(KEY)
    if strategy == 'update-then-delete + double delete':
        time.sleep(0.05); r.delete(KEY)
ROUNDS=1000 READ_DELAY=0ms EXPIRE=0 readers=8 (processes)
delete-then-update                   stale 980/1000 (98.0%)
update-then-delete                   stale 0/1000 (0.0%)
update-then-delete + double delete   stale 0/1000 (0.0%)

ROUNDS=1000 READ_DELAY=0ms EXPIRE=1 readers=8 (processes)
delete-then-update                   stale 983/1000 (98.3%)
update-then-delete                   stale 0/1000 (0.0%)
update-then-delete + double delete   stale 0/1000 (0.0%)

ROUNDS=1000 READ_DELAY=5ms EXPIRE=1 readers=8 (processes)
delete-then-update                   stale 1000/1000 (100.0%)
update-then-delete                   stale 542/1000 (54.2%)
update-then-delete + double delete   stale 0/1000 (0.0%)
A5 缓存击穿的三种做法
MySQL 8.0.44,Redis 7.4.1,Python 3.13(pymysql、redis-py)。数据库查询为 SELECT price, SLEEP(0.05) FROM cache_demo WHERE id = 1,热点键刚过期时 100 个线程同时发起请求,统计查询数据库的次数和每个请求的耗时,逻辑过期的旧价格为 99。每种做法运行两轮。实验只统计查询次数,锁的值固定为 1、用 DELETE 释放;实际使用时按正文写入随机值,释放前确认锁仍是自己的:
def mutex():
    while True:
        v = r.get(KEY)
        if v is not None:
            return int(v)
        if r.set(LOCK, 1, nx=True, ex=3):          # 只有一个请求拿到锁
            try:
                v = r.get(KEY)                     # 再查一次,可能别人已经写回
                if v is None:
                    v = query_db(); r.set(KEY, v, ex=60)
                return int(v)
            finally:
                r.delete(LOCK)
        time.sleep(0.01)                           # 没拿到锁,稍后重新读缓存

def logical():
    d = json.loads(r.get(KEY))                     # 值中带逻辑过期时间
    if d['expire_at'] < time.time() and r.set(LOCK, 1, nx=True, ex=3):
        threading.Thread(target=rebuild).start()   # 后台重建,完成后删除锁
    return d['price']                              # 不等待,直接返回
不加保护  查询数据库  68 次,耗时中位数  157.8 ms,最大  181.4 ms,返回旧值 0 次
互斥锁    查询数据库   1 次,耗时中位数   88.2 ms,最大   95.8 ms,返回旧值 0 次
逻辑过期  查询数据库   1 次,耗时中位数   13.8 ms,最大   19.8 ms,返回旧值 100 次
不加保护  查询数据库 100 次,耗时中位数  408.4 ms,最大  444.2 ms,返回旧值 0 次
互斥锁    查询数据库   1 次,耗时中位数  102.0 ms,最大  118.5 ms,返回旧值 0 次
逻辑过期  查询数据库   1 次,耗时中位数   11.5 ms,最大   18.6 ms,返回旧值 100 次
锁的过期时间短于重建耗时的情况:把查询数据库换成固定休眠 300 ms,锁用 SET NX PX 设置过期时间,不主动释放,模拟锁在重建期间过期,每种设置运行 3 轮:
锁 3000 ms、重建 300 ms:[1, 1, 1] 次回源
锁 100 ms、重建 300 ms:[4, 4, 4] 次回源
A6 布隆过滤器的误判率
Python 3.13 模拟:插入 user:0~user:999999,再查询 user:1000000~user:1999999 这 100 万个不存在的 Key。哈希值取 MD5 的两个 64 位整数 h1、h2,第 i 个位置为 (h1 + i × h2) mod m:
def pos(key):
    d = hashlib.md5(key.encode()).digest()
    h1, h2 = int.from_bytes(d[:8], 'little'), int.from_bytes(d[8:], 'little')
    return [(h1 + i * h2) % m for i in range(k)]
n=1000000 m/n=10 k=7  位数组 1.19 MiB:实测误判率 0.8199%,公式 0.8194%
n=1000000 m/n=10 k=3  位数组 1.19 MiB:实测误判率 1.7588%,公式 1.7411%
n=1000000 m/n=5  k=3  位数组 0.60 MiB:实测误判率 9.2104%,公式 9.1849%
n=1000000 m/n=20 k=14 位数组 2.38 MiB:实测误判率 0.0065%,公式 0.0067%
目标误判率 1.0%:每个 Key 9.59 位,k = 6.6,1 亿个 Key 约 114 MiB
目标误判率 0.1%:每个 Key 14.38 位,k = 10.0,1 亿个 Key 约 171 MiB
A7 空值缓存的内存
向空的 Redis 写入 10 万个随机的商品 ID,值为空字符串,过期时间 60 秒:
for i in range(100000):
    pipe.set(f'product:{random.randrange(10**12)}', '', ex=60)
10 万个空值键 used_memory 增加 14931808,平均每个 149 字节,DBSIZE 100000
A8 大 Key 过期
user:1001:fav 有 100 万个字段,设置 300 毫秒后过期,之后 2 秒内不停发送 PING 并记录最慢的一次;LATENCY LATEST 中的 expire-cycle 是定期删除一次执行的耗时(latency-monitor-threshold 设为 1 毫秒):
lazyfree-lazy-expire no: HLEN 100 万,MEMORY USAGE 64388720,过期后 EXISTS=0,LATENCY expire-cycle 最大 397 ms,期间最慢的 PING 397.8 ms
lazyfree-lazy-expire yes: HLEN 100 万,MEMORY USAGE 64388720,过期后 EXISTS=0,LATENCY 中没有 expire-cycle(低于 1 ms 不记录),期间最慢的 PING 3.6 ms
A9 LRU 的并发访问
JDK 21.0.13,Apple M1 Pro。容量为 1000 的 LinkedHashMap(accessOrder 为 true,重写 removeEldestEntry),先放入 1000 个键;8 个线程各执行 20 万次操作,键在 0~1999 中随机选取,90% 为 get、10% 为 put。一种写法用 ReentrantReadWriteLock,get 加读锁、put 加写锁;另一种 get 和 put 都在同一把锁中执行。结束后读取 size(),并沿链表遍历 keySet():
if (r.nextInt(10) == 0) {
    rw.writeLock().lock(); try { m.put(k, k); } finally { rw.writeLock().unlock(); }
} else {
    rw.readLock().lock();  try { m.get(k); }    finally { rw.readLock().unlock(); }
}
读锁保护 get : 线程结果=[ok] size()=1999 遍历链表得到=1 遍历=ok
读锁保护 get : 线程结果=[ok] size()=1999 遍历链表得到=1 遍历=ok
读锁保护 get : 线程结果=[ok] size()=1999 遍历链表得到=1 遍历=ok
互斥锁       : 线程结果=[ok] size()=1000 遍历链表得到=1000 遍历=ok
互斥锁       : 线程结果=[ok] size()=1000 遍历链表得到=1000 遍历=ok
互斥锁       : 线程结果=[ok] size()=1000 遍历链表得到=1000 遍历=ok
参考资料
- 杨传辉. 大规模分布式存储系统:原理解析与架构实战 [M]. 机械工业出版社, 2013.
- Designing Data-Intensive Applications 中文版
- 缓存那些事
- 一致性哈希算法
- 内容分发网络
- How Aspiration CDN helps to improve your website loading speed?
- Redis: UNLINK
- Redis CLI
- Scaling Memcache at Facebook
- Redis: Bloom filter
- Caffeine: Design
- Caffeine: Eviction
- Caffeine Wiki
- Consistent Hashing and Random Trees: Distributed Caching Protocols for Relieving Hot Spots on the World Wide Web
- Redis: Lazy freeing of objects(redis.conf)
- Canal