计算机操作系统 - 概述
本文目录
基本特征
1. 并发
并发(concurrency)指的是一段时间内有多个程序都在向前推进,并行(parallelism)指的是同一时刻有多个程序在不同的处理器上同时执行。例如单核 CPU 上的编辑器和浏览器轮流运行一个个时间片,看起来同时运行,这是并发;4 核 CPU 上 4 个进程各占一个核同时运行,才是并行。
并行需要硬件支持,如多流水线、多核处理器或者分布式计算系统。
操作系统通过引入进程和线程,使得程序能够并发运行。
2. 共享
共享是指系统中的资源可以被多个并发进程共同使用。
有两种共享方式:互斥共享和同时共享。
互斥共享的资源称为临界资源,例如打印机等,在同一时刻只允许一个进程访问,需要用同步机制来实现互斥访问。
同时共享的资源允许多个进程在一段时间内交替或同时访问,例如多个进程同时读取磁盘上的同一个文件。
3. 虚拟
虚拟技术把一个物理实体转换为多个逻辑实体。
主要有两种虚拟技术:时(时间)分复用技术和空(空间)分复用技术。
多个进程能在同一个处理器上并发执行使用了时分复用技术,让每个进程轮流占用处理器,每次只执行一小个时间片并快速切换。
虚拟内存使用了空分复用技术,它将物理内存抽象为地址空间,每个进程都有各自的地址空间。地址空间的页被映射到物理内存,地址空间的页并不需要全部在物理内存中,当使用到一个没有在物理内存的页时,产生缺页异常,把该页调入内存;内存已满时,还要用页面置换算法选择一页换出。
4. 异步
异步指进程不是一次性执行完毕,而是走走停停,以不可知的速度向前推进。
基本功能
1. 进程管理
进程控制、进程同步、进程通信、死锁处理、处理机调度等。
2. 内存管理
内存分配、地址映射、内存保护与共享、虚拟内存等。
3. 文件管理
文件存储空间的管理、目录管理、文件读写管理和保护等。
4. 设备管理
完成用户的 I/O 请求,方便用户使用各种设备,并提高设备的利用率。
主要包括缓冲管理、设备分配、设备处理、虚拟设备等。
系统调用
CPU 通过特权级(privilege level)限制程序能做的事。x86 上用当前特权级(Current Privilege Level, CPL)表示,取值为 0~3,数字越小权限越高。操作系统内核运行在 0 级,称为内核态(kernel mode);应用程序运行在 3 级,称为用户态(user mode)。
两种状态的区别在于能执行的指令和能访问的内存:内核态可以执行全部指令,能访问内核空间和用户空间;用户态不能执行特权指令,只能访问页表中标为用户可访问(U/S 位为 1)的页,即本进程的用户空间。
划分两种状态是为了保护内核和其它进程。如果应用程序能随意修改页表基址寄存器 CR3,就能访问其它进程的内存;如果能直接操作磁盘和网卡,就绕过了文件系统和网络协议栈的管理。因此修改 CR3、加载 GDT 等特权指令只能在 CPL 为 0 时执行,用户程序执行时会产生通用保护异常(General Protection Exception, #GP)。
应用程序需要内核完成的工作,例如读写文件、创建进程、收发网络数据,只能通过系统调用(system call)请求内核。系统调用是用户态进入内核态的受控入口:陷入时跳转的地址由内核预先设定(x86-64 上由内核写入 IA32_LSTAR 寄存器),程序不能指定跳转的地址,否则就能跳到内核的任意位置。
Linux 的系统调用主要有以下这些:
| 类别 | 系统调用 |
|---|---|
| 进程控制 | fork(); exit(); wait(); |
| 进程通信 | pipe(); shmget(); mmap(); |
| 文件操作 | open(); read(); write(); |
| 设备操作 | ioctl(); read(); write(); |
| 信息维护 | getpid(); alarm(); nanosleep(); |
| 安全 | chmod(); umask(); chown(); |
fork 调用一次、返回两次,以及 fork 与 clone 的关系,见进程与线程的区别。
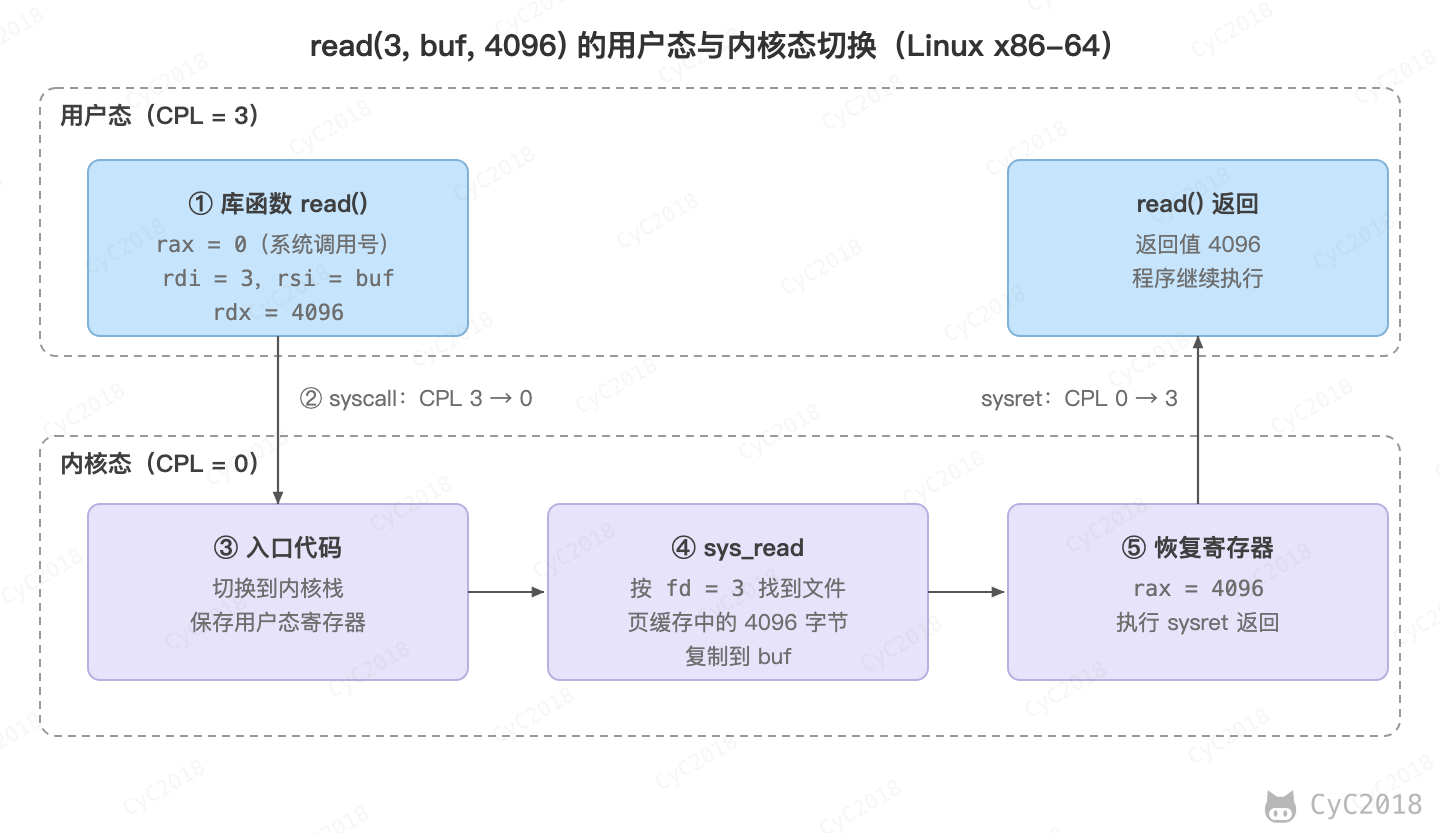
以 read(3, buf, 4096) 为例(Linux x86-64,见下图):读取文件描述符 3 指向的文件,最多 4096 字节放入用户缓冲区 buf。整个过程分为以下几步:
- C 库的 read() 把系统调用号放入 rax(read 在 x86-64 上的编号为 0),把参数放入 rdi、rsi、rdx;
- 执行 syscall 指令,CPU 切换到特权级 0,把下一条指令的地址存入 rcx,把 RFLAGS 存入 r11,然后跳转到内核入口;这条指令不保存栈指针 RSP;
- 入口代码切换到当前进程的内核栈,把用户态的 RIP、RSP、RFLAGS 和其它寄存器保存到内核栈上,再调用 do_syscall_64,按编号查系统调用表,找到 sys_read;
- sys_read 在当前进程的文件描述符表中按下标 3 找到 open() 时建立的文件对象,页缓存中有数据时,把 4096 字节复制到 buf,返回值为 4096(剩余不足时返回实际读到的字节数);
- 内核恢复寄存器,执行 sysret,CPU 回到特权级 3,从 rcx 保存的地址继续执行,C 库把 rax 中的 4096 作为 read() 的返回值交给调用者。
第 4 步中,内核不直接使用用户传入的指针,而是通过 copy_to_user 等函数访问用户缓冲区,这些函数会先检查地址。
进入内核态有三种途径:程序主动执行的系统调用(陷入,例如 read()),指令执行时引起的异常(例如缺页、除数为 0),以及来自 CPU 外部的外中断(例如时钟中断、网卡收到数据包),见中断分类。异常和外中断返回时使用 iret,系统调用通常使用 sysret 返回。
陷入和返回本身需要的时间并不少。在 Linux 上实测(arm64,见附录 A1),一次普通函数调用约 1 ns,glibc 的 getppid() 约 167 ns,直接执行陷入指令约 165 ns,一次系统调用的耗时接近普通函数调用的 180 倍。getppid 在内核中的工作很少,测得的时间基本就是进入和退出内核的代价。具体数字与 CPU 和内核配置有关,x86-64 上启用 PTI 时会更高。
开销由以下几部分组成:
- 特权级切换,以及寄存器的保存和恢复;
- 内核入口和出口的额外工作,例如启用页表隔离(Page Table Isolation, PTI,用于缓解 Meltdown 攻击)时,每次进入和退出内核都要写 CR3,内核文档给出的量级是一百个周期左右;
- 内核执行的工作本身,例如参数检查、查找文件、复制数据。
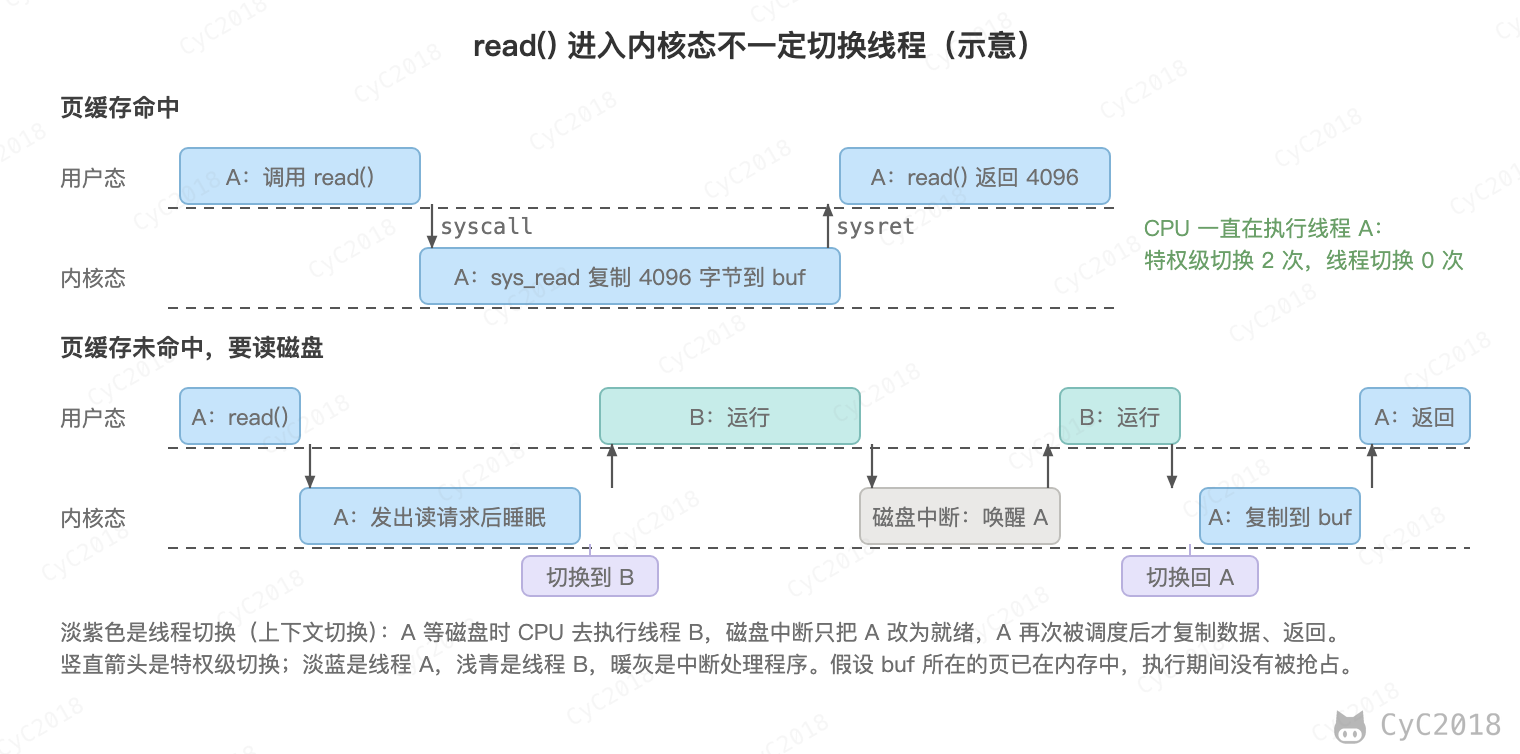
需要注意的是,陷入内核不等于切换线程。上面的 read() 命中页缓存,且执行期间没有阻塞或被抢占时,内核复制完数据就返回,CPU 一直在执行同一个线程,只发生了两次特权级切换。
未命中时要等待磁盘,内核发出读请求后让线程睡眠,调度其它线程运行,这就发生了上下文切换(见进程管理),磁盘读完后由中断唤醒它,它再次被调度时才复制数据并返回。
写文件同样不一定等待磁盘。write(fd, buf, 4096) 陷入内核后,内核把 buf 的内容复制到页缓存(page cache,内存中的文件缓存)并标记为脏页,然后返回 4096。此时数据未必已经写到磁盘,磁盘写入由内核之后异步完成,或由 fsync() 强制完成。
减少系统调用开销的做法主要有以下几种:
- 批量处理:writev 一次系统调用写入多个缓冲区(writev(2));
- 在用户态完成:vDSO(virtual dynamic shared object)是内核自动映射到每个进程中的一小段共享代码,在支持的时钟源上,clock_gettime 等调用不再陷入内核(vdso(7)),实测经 vDSO 约 18 ns,绕过 vDSO 直接陷入约 202 ns。经 vDSO 完成的调用不进入内核,也不会出现在 strace 的输出中;
- 内存映射:mmap 把文件映射到用户地址空间,之后直接读写内存,不需要每次调用 read() 和 write(),但缺页时仍会陷入内核(内存映射文件见 Java IO);
- 零拷贝(zero-copy):sendfile 在内核中把文件内容直接送到 socket,数据不经过用户缓冲区,read() 和 write() 两次调用也合并为一次(sendfile(2)),Kafka 的 broker 发送消息就是这样做的,见消息队列。
排查系统调用的开销时,可以用 strace -c 统计各系统调用的次数,用 strace -T 查看每次调用的耗时(strace(1))。
宏内核和微内核
1. 宏内核
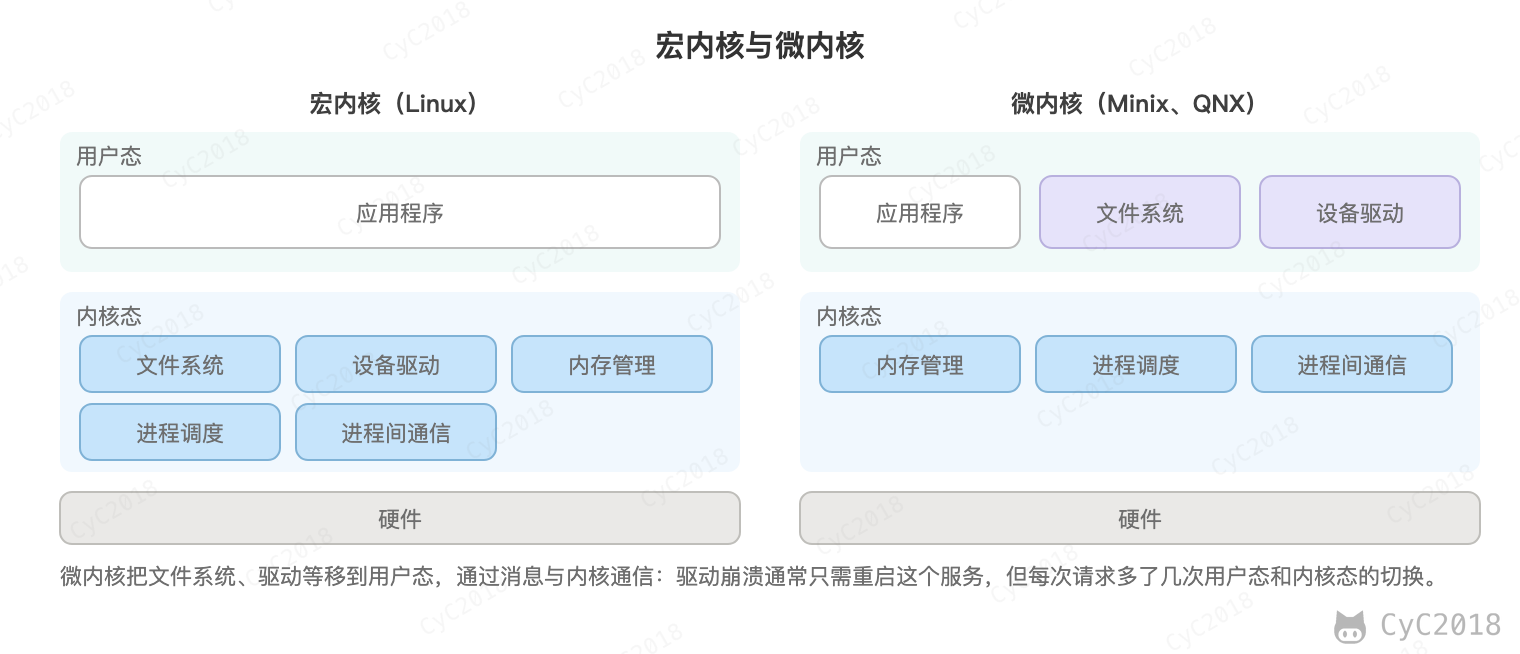
宏内核是将操作系统功能作为一个紧密结合的整体放到内核。
文件系统、设备驱动、内存管理等模块运行在同一个内核地址空间中,相互之间直接通过函数调用协作,因此性能高;缺点是任何一个模块出错(例如有缺陷的驱动)都可能使整个系统崩溃。Linux 是宏内核。
2. 微内核
由于操作系统越来越复杂,因此将一部分操作系统功能移出内核,从而降低内核的复杂性。移出的部分根据分层的原则划分成若干服务,相互独立。
在微内核结构下,操作系统被划分成小的、定义良好的模块,只有微内核这一个模块运行在内核态,其余模块运行在用户态。
例如应用程序读文件时,请求经微内核转发给用户态的文件系统服务,文件系统服务再经微内核向磁盘驱动服务发消息,结果沿原路返回;宏内核中同样的请求只需陷入一次内核。多出的消息传递和特权级切换会带来一定的性能损失。
中断分类
进入内核态的事件按引起的原因分为外中断、异常和陷入三类。外中断和异常通过中断描述符表(Interrupt Descriptor Table, IDT)找到处理程序,特权级切换时,硬件把旧的 SS、RSP、RFLAGS、CS、RIP 压入内核栈(Intel SDM Vol. 3A 第 7 章)。系统调用则由 syscall 指令直接跳转,不经过 IDT。
1. 外中断
外中断(external interrupt)由 CPU 外部的事件引起,与当前执行的指令无关,因此是异步的。例如磁盘完成 I/O 后发出 I/O 完成中断,表示设备的输入输出已经完成,处理器可以发送下一个 I/O 请求;时钟中断周期性地到来,是时间片轮转的基础。外中断经由 CPU 引脚或本地 APIC(Advanced Programmable Interrupt Controller)送达。
2. 异常
异常(exception)由正在执行的指令引起,是同步的,指令执行到哪里,异常就在哪里发生。例如第一次写刚分配的内存时,访问的地址还没有映射到物理页,会触发缺页异常(page fault),内核分配物理页后,同一条指令可以重新执行(见虚拟内存);执行除法指令时除数为 0,会触发除法错误(#DE);遇到非法操作码会触发 #UD。
需要注意的是,x86 上整数加法溢出只设置标志位,不会产生异常,因此这里用除数为 0 作例子。
3. 陷入
陷入(trap)由程序主动执行的指令引起,同样是同步的。系统调用就是通过陷入实现的:x86-64 上是 syscall 指令,arm64 上是 svc 指令(syscalls(2))。
Intel 手册中的 trap 指异常在指令执行之后报告,例如 INT3、INTO;syscall 不属于 IDT 中的异常,因此两者的含义并不完全相同。
附录:实测
A1 普通函数调用与系统调用的耗时
环境:Docker Desktop 的 Linux 虚拟机,Ubuntu 24.04 容器,内核 6.10.14-linuxkit(aarch64,宿主为 Apple M1 Pro),gcc 13.3.0,编译选项 -O2。arm64 上 getppid 的系统调用号为 173,陷入指令为 svc #0。核心代码如下:
static __attribute__((noinline)) long add1(long x) { return x + 1; }

static long raw_getppid(void) {
    register long x8 asm("x8") = SYS_getppid;   /* 系统调用号放在 x8 */
    register long x0 asm("x0");                 /* 返回值在 x0 */
    asm volatile("svc #0" : "=r"(x0) : "r"(x8) : "memory", "cc");
    return x0;
}

/* 每种方式循环 10^7 次,clock_gettime(CLOCK_MONOTONIC) 计时,7 轮取中位数 */
for (long i = 0; i < n; i++) x = add1(x);                                   /* function_call */
for (long i = 0; i < n; i++) acc += getppid();                              /* getppid_libc */
for (long i = 0; i < n; i++) acc += raw_getppid();                          /* svc_raw_getppid */
for (long i = 0; i < n; i++) clock_gettime(CLOCK_MONOTONIC, &ts);           /* clock_gettime_vdso */
for (long i = 0; i < n; i++) syscall(SYS_clock_gettime, CLOCK_MONOTONIC, &ts);  /* clock_gettime_syscall */
原始输出(三次独立运行,单位为每次调用的纳秒数):
run  function_call  getppid_libc  svc_raw_getppid  clock_gettime_vdso  clock_gettime_syscall
1    0.94           167.44        165.26           18.01               201.36
2    0.94           167.24        165.26           17.94               201.85
3    0.95           167.81        165.21           17.94               202.94
反汇编显示循环体调用的是 add1(bl add1),直接陷入的路径中是 mov x8, #0xad 和 svc #0x0。glibc 的 getppid 与直接 svc 只相差约 2 ns,说明主要开销在陷入本身,而不是库函数的包装。
参考资料
- Tanenbaum A S, Bos H. Modern Operating Systems [M]. Pearson, 2014.
- Silberschatz A, Galvin P B, Gagne G. Operating System Concepts [M]. Wiley, 2018.
- Arpaci-Dusseau R H, Arpaci-Dusseau A C. Operating Systems: Three Easy Pieces [M]. Arpaci-Dusseau Books, 2018. 第 6 章 Mechanism: Limited Direct Execution(在线版)。
- Intel. Intel® 64 and IA-32 Architectures Software Developer's Manual, Volume 2B(SYSCALL、SYSRET)和 Volume 3A(第 6、7 章)[M]. Intel, 2026(SDM 下载页)。
- syscalls(2)、syscall(2)、write(2)、writev(2)、sendfile(2)、vdso(7)、strace(1)。
- Linux 内核源码:syscall_64.tbl、entry_64.S、uaccess.h、Page Table Isolation (PTI)。