Java 基础
一、数据类型
基本类型
- byte/8
- char/16
- short/16
- int/32
- float/32
- long/64
- double/64
- boolean/~
boolean 只有两个值:true、false,可以使用 1 bit 来存储,但是具体大小没有明确规定。编译器会把 boolean 类型的数据编译为 int,使用 1 来表示 true,0 表示 false。JVM 支持 boolean 数组,但是是通过读写 byte 数组来实现的。
包装类型
基本类型都有对应的包装类型,基本类型与其对应的包装类型之间的赋值使用自动装箱与拆箱完成。
Integer x = 2;     // 装箱 调用了 Integer.valueOf(2)
int y = x;         // 拆箱 调用了 x.intValue()
需要注意的是,对 null 拆箱会抛出 NullPointerException,例如 Map<String, Integer> 中没有这个键时,int n = map.get("order1024"); 就会抛出异常。Integer n = hit ? map.get("order1024") : 0; 也一样:两个分支的类型分别是 Integer 和 int,条件表达式的类型就是 int,hit 为 true 而 get() 返回 null 时同样要拆箱。
缓存池
new Integer(123) 与 Integer.valueOf(123) 的区别在于:
- new Integer(123) 每次都会新建一个对象;
- Integer.valueOf(123) 会使用缓存池中的对象,多次调用会取得同一个对象的引用。
Integer x = new Integer(123);
Integer y = new Integer(123);
System.out.println(x == y);    // false
Integer z = Integer.valueOf(123);
Integer k = Integer.valueOf(123);
System.out.println(z == k);   // true
需要注意的是,new Integer(123) 从 JDK 9 起已经废弃,JDK 16 起标记为将要删除,编译时会给出警告,应该使用 Integer.valueOf(123)。
valueOf() 先判断值是否在缓存池的范围内,在的话直接返回缓存中的对象。
public static Integer valueOf(int i) {
    if (i >= IntegerCache.low && i <= IntegerCache.high)
        return IntegerCache.cache[i + (-IntegerCache.low)];
    return new Integer(i);
}
自动装箱调用的就是 valueOf(),因此值相同且在缓存范围内的 Integer 引用同一个对象。
Integer m = 123;
Integer n = 123;
System.out.println(m == n); // true
各包装类型的缓存池如下(JDK 21 实测,见附录 A1):
- Boolean:true 和 false;
- Byte:全部 256 个值;
- Short、Integer、Long:-128~127;
- Character:0~127,即 \u0000~\u007F;
- Float、Double 没有缓存池。
超出范围时不保证复用对象,默认配置下两个值为 128 的 Integer 用 == 比较为 false,所以比较包装类型的值要用 equals()。需要注意的是,equals() 不做类型转换,Long.valueOf(1).equals(1) 为 false,HashMap<Long, String> 调用 get(1) 时参数被装箱为 Integer,与 Long 类型的键不相等,也查不到;Integer 与 int 用 == 比较时,Integer 会拆箱,比较的是数值。
Integer 缓存池的上界可以调整:启动时加上 -XX:AutoBoxCacheMax=1000,IntegerCache 初始化时会读取这个值,之后 Integer.valueOf(128) 也会返回同一个对象。其它包装类型的缓存范围是固定的。
二、String
概览
String 被声明为 final,因此它不可被继承(Integer 等包装类也不能被继承)。否则子类可以加入可变的状态,再当作 String 传给其它代码,破坏不可变。
在 Java 8 中,String 内部使用 char 数组存储数据。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final char value[];
}
从 Java 9 开始,String 类的实现改用 byte 数组存储字符串,同时使用 coder 来标识使用了哪种编码(紧凑字符串,JEP 254):只包含 Latin-1 字符的字符串每个字符占 1 个字节,coder 为 0;含有中文等其它字符时按 UTF-16 存储,每个 char 占 2 个字节,coder 为 1。只含 Latin-1 字符时字符数据减半,但仍有 String 对象、数组头和对齐填充的开销,所以短字符串省得少、长字符串接近一半,例如 12 个字符的字符串从 64 字节变为 56 字节,1000 个字符时从 2040 字节变为 1040 字节(JDK 21,与关闭紧凑字符串时对比,见附录 A2)。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final byte[] value;

    /** The identifier of the encoding used to encode the bytes in {@code value}. */
    private final byte coder;
}
value 数组被声明为 final,这只意味着 value 初始化之后不能再引用其它数组,数组中的内容仍然可以修改。真正保证 String 不可变的是:value 为 private,String 内部没有改变 value 数组的方法,也不把它交给外部代码。
不可变的好处
1. 可以缓存哈希值
String 的哈希值经常被使用,例如 String 用作 HashMap 的 key。内容不会变,哈希值也就不会变,第一次调用 hashCode() 时算出并保存在 hash 字段中,之后直接返回。
2. String Pool 的需要
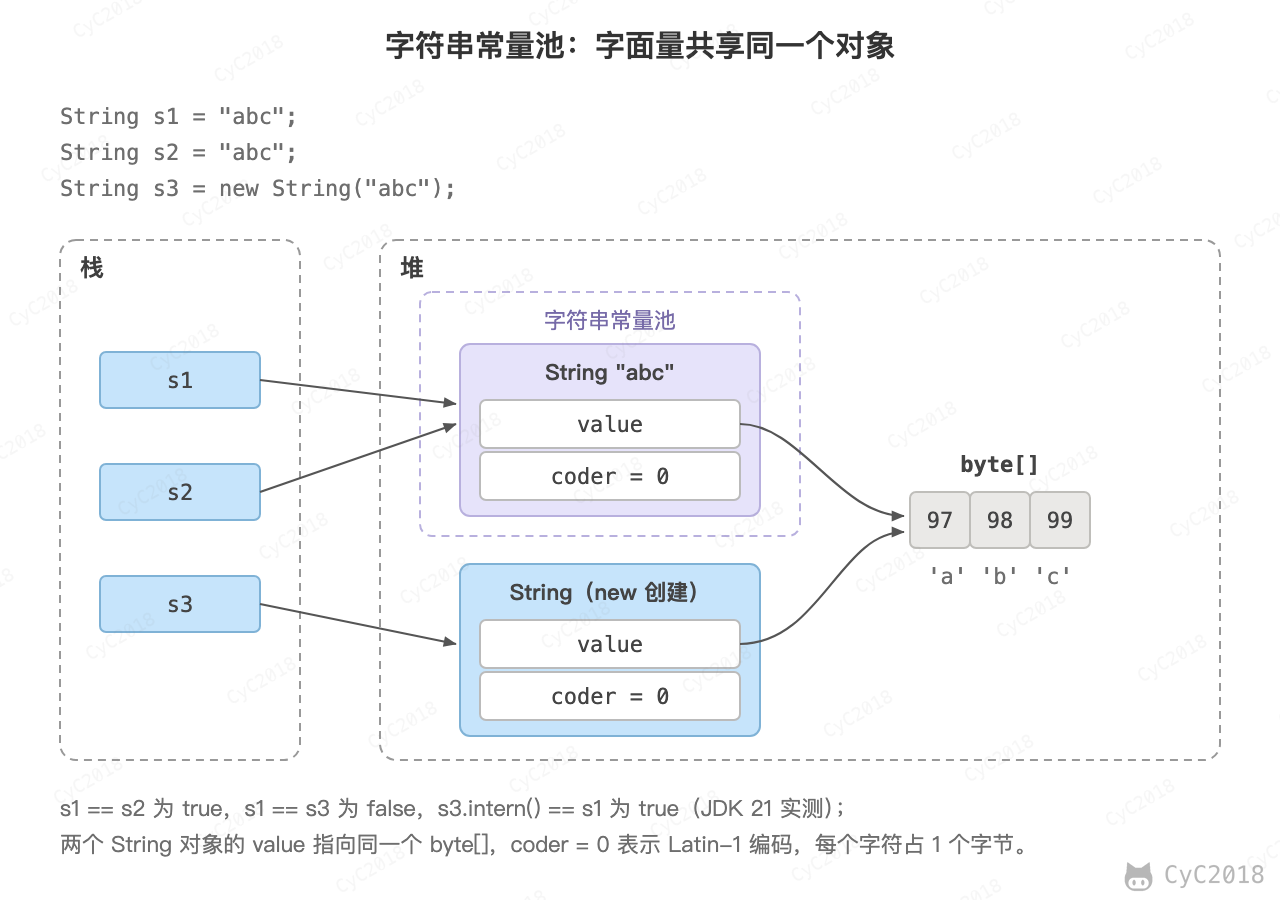
用字面量创建字符串时,如果 String Pool 中已经有内容相同的字符串,就直接取得池中对象的引用。只有 String 是不可变的,才可能使用 String Pool:下图中 s1 和 s2 引用的是同一个对象,如果可以通过 s1 修改它,s2 的值也会跟着改变。
3. 安全性
String 经常作为参数,不可变可以保证参数在使用过程中不被修改。例如一个方法先检查传入的主机名是否允许访问,再用它建立连接;如果 String 可变,调用方可以在检查通过之后把它改成另一台主机,实际连接的就不是检查过的那一台。
4. 线程安全
String 不可变性天生具备线程安全,可以在多个线程中安全地使用。
String, StringBuffer and StringBuilder
- 可变性:String 不可变,StringBuffer 和 StringBuilder 可变;
- 线程安全:String 不可变,因此是线程安全的;StringBuffer 的方法使用 synchronized 进行同步,是线程安全的;StringBuilder 不是线程安全的,但没有加锁的开销,单线程中拼接字符串时使用它。
用 + 拼接字符串时,JDK 8 的编译器生成 StringBuilder 的 append() 调用,JDK 9 起改为 invokedynamic(JEP 280),JDK 21 运行时先算出总长度、直接填充结果的 byte 数组,不再经过 StringBuilder;用 --release 8 编译的类仍是 StringBuilder 的调用。但在循环中用 + 拼接,每次循环仍会创建一个新的 String 对象并复制之前的内容,例如拼接 10000 次 "x" 共分配约 50 MB,改用 StringBuilder 只分配约 47 KB(JDK 21,见附录 A2)。所以应该在循环外创建一个 StringBuilder,在循环中调用 append()。
只由基本类型或字符串的字面量(不含 null)和常量变量(用常量表达式初始化的 final 基本类型或 String 变量)组成的字符串拼接是编译期常量,编译器直接算出结果放进常量池;有普通变量或方法返回值参与时,每次都在运行时创建新的对象(JLS §15.18.1、§15.29),连 s + "" 也不例外(JDK 21 实测,见附录 A2):
String s = "order1024";
final String f = "order";
String v = "order";
System.out.println(("order" + "1024") == s);   // true
System.out.println((f + "1024") == s);         // true
System.out.println((v + "1024") == s);         // false
System.out.println((s + "") == s);             // false
String Pool
字符串常量池(String Pool)保存着所有字符串字面量(literal strings),这些字面量在编译时期就确定。不仅如此,还可以使用 String 的 intern() 方法在运行过程将字符串添加到 String Pool 中。
当一个字符串调用 intern() 方法时,如果 String Pool 中已经存在一个字符串和该字符串值相等(使用 equals() 方法进行确定),那么就会返回 String Pool 中字符串的引用;否则,就会在 String Pool 中添加一个新的字符串,并返回这个新字符串的引用。
下面示例中,s1 和 s2 采用 new String() 的方式新建了两个不同字符串。字面量 "aaa" 在执行 new String("aaa") 时已经进入 String Pool,s1.intern() 和 s2.intern() 返回的都是池中的这个对象,因此 s3 和 s4 引用的是同一个字符串。
String s1 = new String("aaa");
String s2 = new String("aaa");
System.out.println(s1 == s2);           // false
String s3 = s1.intern();
String s4 = s2.intern();
System.out.println(s3 == s4);           // true
如果是采用 "bbb" 这种字面量的形式创建字符串,会自动地将字符串放入 String Pool 中。
String s5 = "bbb";
String s6 = "bbb";
System.out.println(s5 == s6);  // true
Java 6 及以前,String Pool 中的字符串放在永久代,Java 7 起移到了堆中(各区域的划分见 方法区)。永久代的大小有上限,大量调用 intern() 的程序容易出现 OutOfMemoryError: PermGen space;移到堆中也是逐步去掉永久代的一步,Java 8 用元空间取代了永久代。
移到堆中之后,池中没有相等的字符串时,intern() 不再像 Java 6 那样把字符串复制到永久代,而是在池中记录堆中这个对象的引用,所以运行时拼接出的 "order1024" 调用 intern() 返回的就是它自己(JDK 21 实测,见附录 A2)。
需要注意的是,返回的是不是自己取决于运行时池中是否已经有相等的字符串,不能只按规则推断。JDK 自带的类数据共享(CDS)归档在启动时就放入了 "java"、"11" 等常见字符串,所以在附录的环境中(JDK 21,先编译再运行),new String("1") + new String("1") 调用 intern() 默认返回的不是自己,加 -Xshare:off 关闭 CDS 后才是。
new String("abc")
使用这种方式一共会创建两个字符串对象(前提是 String Pool 中还没有 "abc" 字符串对象)。
- "abc" 属于字符串字面量,编译时记录在 class 文件的常量池中,HotSpot 通常在运行时第一次执行到对应的 ldc 指令时才解析它(见 解析),在 String Pool 中创建这个字符串对象,之后再执行就直接复用;
- 而使用 new 的方式会在堆中创建一个字符串对象。
创建一个测试类,其 main 方法中使用这种方式来创建字符串对象。
public class NewStringTest {
    public static void main(String[] args) {
        String s = new String("abc");
    }
}
使用 javap -verbose 进行反编译,得到以下内容:
// ...
Constant pool:
// ...
   #7 = Class              #8             // java/lang/String
   #8 = Utf8               java/lang/String
   #9 = String             #10            // abc
  #10 = Utf8               abc
// ...

  public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: (0x0009) ACC_PUBLIC, ACC_STATIC
    Code:
      stack=3, locals=2, args_size=1
         0: new           #7                  // class java/lang/String
         3: dup
         4: ldc           #9                  // String abc
         6: invokespecial #11                 // Method java/lang/String."<init>":(Ljava/lang/String;)V
         9: astore_1
// ...
在 class 文件的常量池中,#10 存储字符串字面量 "abc",#9 是 String 类型的常量,它指向 #10;运行时解析 #9 得到的就是 String Pool 中的字符串对象。在 main 方法中,0: 行使用 new #7 在堆中创建一个字符串对象,并且使用 ldc #9 将 String Pool 中的字符串对象作为 String 构造函数的参数。
以下是 JDK 21 中 String 构造函数的源码,可以看到,在将一个字符串对象作为另一个字符串对象的构造函数参数时,并不会完全复制 value 数组内容,而是都会指向同一个 value 数组,即 String Pool 的需要 一节配图中的 s3。
public String(String original) {
    this.value = original.value;
    this.coder = original.coder;
    this.hash = original.hash;
    this.hashIsZero = original.hashIsZero;
}
三、运算
参数传递
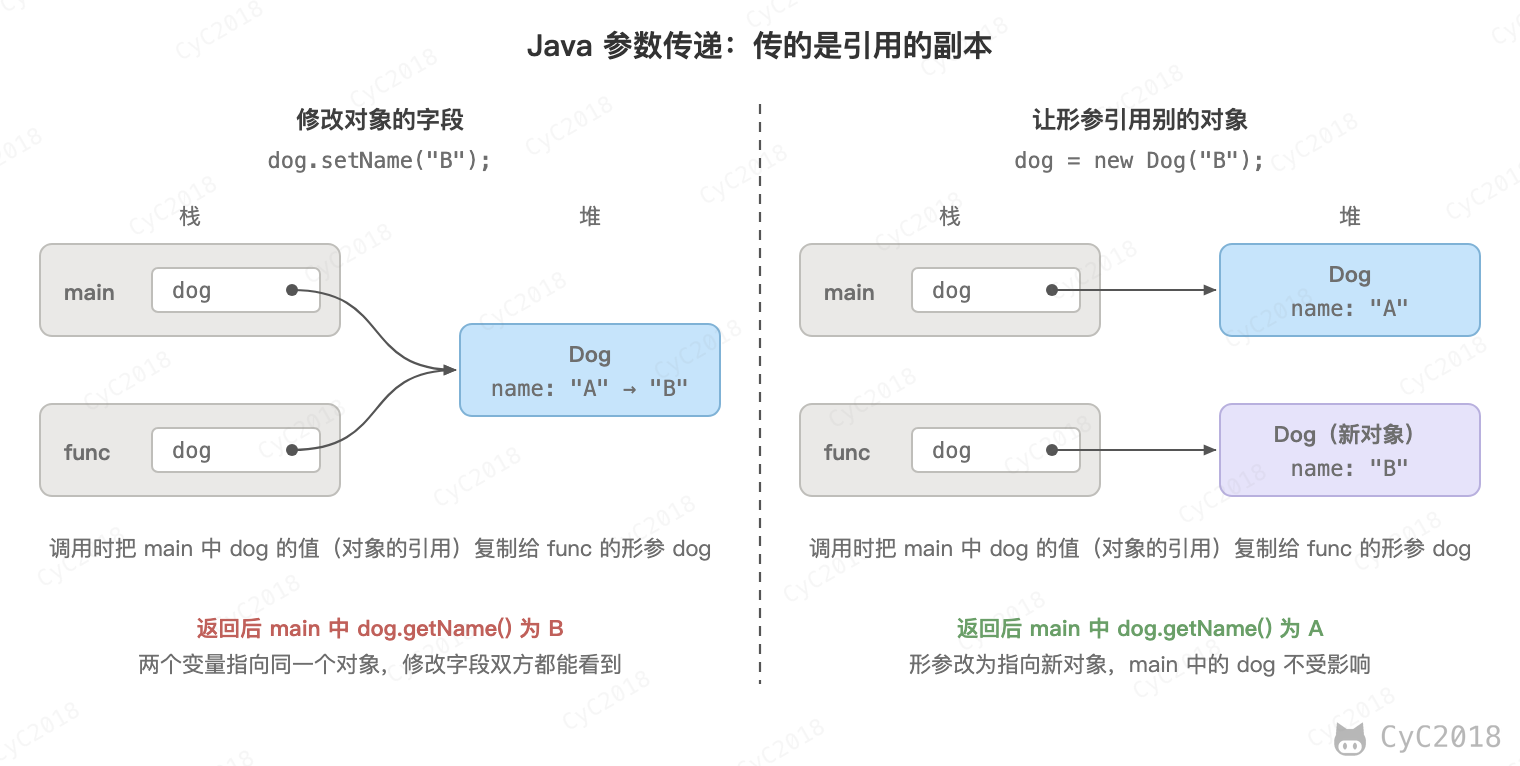
Java 的参数是以值传递的形式传入方法中,而不是引用传递。
以下代码中 Dog dog 的 dog 是一个指针,存储的是对象的地址。在将一个参数传入一个方法时,本质上是将对象的地址以值的方式传递到形参中。
public class Dog {

    String name;

    Dog(String name) {
        this.name = name;
    }

    String getName() {
        return this.name;
    }

    void setName(String name) {
        this.name = name;
    }

    String getObjectAddress() {
        return super.toString();
    }
}
在方法中改变对象的字段值会改变原对象该字段值,因为引用的是同一个对象。
class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        func(dog);
        System.out.println(dog.getName());          // B
    }

    private static void func(Dog dog) {
        dog.setName("B");
    }
}
但是在方法中将指针引用了其它对象,那么此时方法里和方法外的两个指针指向了不同的对象,在一个指针改变其所指向对象的内容对另一个指针所指向的对象没有影响。
public class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        func(dog);
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        System.out.println(dog.getName());          // A
    }

    private static void func(Dog dog) {
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        dog = new Dog("B");
        System.out.println(dog.getObjectAddress()); // Dog@74a14482
        System.out.println(dog.getName());          // B
    }
}
两种情况的区别如下图。需要注意的是,getObjectAddress() 输出的 @ 后面是哈希码,不是内存地址,这里只用来区分对象。
float 与 double
Java 不能隐式执行向下转型,因为这会使得精度降低。
1.1 字面量属于 double 类型,不能直接将 1.1 直接赋值给 float 变量,因为这是向下转型。
// float f = 1.1;
1.1f 字面量才是 float 类型。
float f = 1.1f;
隐式类型转换
s1 + 1 的结果是 int 类型,不能隐式地向下转型为 short。short s1 = 1 能编译通过,是因为 1 是常量且在 short 的范围内,编译器允许这种赋值。
short s1 = 1;
// s1 = s1 + 1;
但是使用 += 或者 ++ 运算符会执行隐式类型转换。
s1 += 1;
s1++;
上面的语句相当于将 s1 + 1 的计算结果进行了向下转型:
s1 = (short) (s1 + 1);
switch
从 Java 7 开始,可以在 switch 条件判断语句中使用 String 对象。
String s = "a";
switch (s) {
    case "a":
        System.out.println("aaa");
        break;
    case "b":
        System.out.println("bbb");
        break;
}
switch 不支持 long、float、double,这是因为 switch 编译后的 tableswitch 和 lookupswitch 指令只能按 int 值跳转。对 String 使用 switch 时,编译器先按 hashCode() 跳转,再用 equals() 比较(JDK 21 javap 实测,见附录 A2)。
// long x = 111;
// switch (x) { // error: selector type long is not allowed
//     case 111:
//         System.out.println(111);
//         break;
//     case 222:
//         System.out.println(222);
//         break;
// }
从 Java 14 开始,switch 还可以作为表达式使用。case 后面用 -> 时不会贯穿到下一个分支,不需要 break:
int days = switch (month) {
    case 2 -> 28;
    case 4, 6, 9, 11 -> 30;
    default -> 31;
};
Java 21 起 switch 还可以按类型匹配,见 Java 各版本的新特性。
四、关键字
final
1. 数据
声明数据为常量,可以是编译时常量,也可以是在运行时被初始化后不能被改变的常量。
- 对于基本类型,final 使数值不变;
- 对于引用类型,final 使引用不变,也就不能引用其它对象,但是被引用的对象本身是可以修改的。
final int x = 1;
// x = 2;  // cannot assign value to final variable 'x'
final A y = new A();
y.a = 1;
final 字段只能赋值一次,实例字段要在构造函数结束前赋值。用常量表达式初始化的基本类型或 String 类型的 static final 字段是编译时常量,值直接写进使用它的类,读取它不会触发所在类的初始化(JDK 21 实测,见附录 A11)。
2. 方法
声明方法不能被子类重写。
private 方法隐式地被指定为 final,如果在子类中定义的方法和基类中的一个 private 方法签名相同,此时子类的方法不是重写基类方法,而是在子类中定义了一个新的方法。
3. 类
声明类不允许被继承。
final 与 finally、finalize() 只是名字相近,区别见 异常。
static
1. 静态变量
- 静态变量:又称为类变量,属于类而不属于某个实例,类所有的实例都共享静态变量,可以直接通过类名来访问它,静态变量在内存中只存在一份,JDK 7 起随 Class 对象放在堆中,通常一直存在到程序结束;
- 实例变量:每创建一个实例就会产生一个实例变量,它与该实例同生共死。
public class A {

    private int x;         // 实例变量
    private static int y;  // 静态变量

    public static void main(String[] args) {
        // int x = A.x;  // Non-static field 'x' cannot be referenced from a static context
        A a = new A();
        int x = a.x;
        int y = A.y;
    }
}
2. 静态方法
静态方法属于类,不依赖于任何实例,也不能被子类重写(见重写),所以不能是抽象方法,必须有实现。
public abstract class A {
    public static void func1(){
    }
    // public abstract static void func2();  // Illegal combination of modifiers: 'abstract' and 'static'
}
静态方法没有当前对象,不能直接访问实例字段和实例方法,也不能使用 this 和 super,但可以通过对象引用访问实例成员。
public class A {

    private static int x;
    private int y;

    public static void func1(){
        int a = x;
        // int b = y;  // Non-static field 'y' cannot be referenced from a static context
        // int b = this.y;     // 'A.this' cannot be referenced from a static context
    }
}
3. 静态语句块
静态语句块在类初始化时运行一次,类在第一次被主动使用(例如 new 对象、调用静态方法)时初始化,见 类初始化时机。
虚拟机保证类初始化只由一个线程执行,静态内部类实现的单例就利用了这一点;初始化之后再修改静态变量仍然需要同步。
public class A {
    static {
        System.out.println("123");
    }

    public static void main(String[] args) {
        A a1 = new A();
        A a2 = new A();
    }
}
123
4. 静态内部类
非静态内部类依赖于外部类的实例,也就是说需要先创建外部类实例,才能用这个实例去创建非静态内部类。而静态内部类不需要。
public class OuterClass {

    class InnerClass {
    }

    static class StaticInnerClass {
    }

    public static void main(String[] args) {
        // InnerClass innerClass = new InnerClass(); // 'OuterClass.this' cannot be referenced from a static context
        OuterClass outerClass = new OuterClass();
        InnerClass innerClass = outerClass.new InnerClass();
        StaticInnerClass staticInnerClass = new StaticInnerClass();
    }
}
静态内部类没有外部类的实例,不能直接访问外部类的实例变量和实例方法。
5. 静态导包
在使用静态变量和方法时不用再指明 ClassName,从而简化代码,但可读性大大降低。
import static com.xxx.ClassName.*;
6. 初始化顺序
静态变量和静态语句块只在类初始化时执行一次;之后每次创建对象,先执行实例变量和普通语句块,最后执行构造函数。同一类成员按它们在代码中出现的顺序执行。
存在继承时,先执行父类和子类的静态部分,再依次执行父类、子类的实例部分和构造函数:
class Parent {
    static String sf = log("父类静态变量");
    static { log("父类静态语句块"); }
    String f = log("父类实例变量");
    { log("父类普通语句块"); }
    Parent() { log("父类构造函数"); }
    static String log(String s) { System.out.println(s); return s; }
}

class Child extends Parent {
    static String sf = log("子类静态变量");
    static { log("子类静态语句块"); }
    String f = log("子类实例变量");
    { log("子类普通语句块"); }
    Child() { log("子类构造函数"); }
}
new Child()            第二次 new Child()
父类静态变量
父类静态语句块
子类静态变量
子类静态语句块
父类实例变量           父类实例变量
父类普通语句块         父类普通语句块
父类构造函数           父类构造函数
子类实例变量           子类实例变量
子类普通语句块         子类普通语句块
子类构造函数           子类构造函数
五、Object 通用方法
概览
JDK 21 中 Object 的公有和受保护方法:
public native int hashCode()

public boolean equals(Object obj)

protected native Object clone() throws CloneNotSupportedException

public String toString()

public final native Class<?> getClass()

protected void finalize() throws Throwable {}   // JDK 9 起废弃,JDK 18 起标记为将要删除

public final native void notify()

public final native void notifyAll()

public final void wait(long timeoutMillis) throws InterruptedException   // 内部调用私有的 native 方法 wait0()

public final void wait(long timeoutMillis, int nanos) throws InterruptedException

public final void wait() throws InterruptedException
equals()
1. 等价关系
两个对象具有等价关系,需要满足以下五个条件:
- 自反性:x.equals(x) 为 true;
- 对称性:x.equals(y) 与 y.equals(x) 的结果相同;
- 传递性:x.equals(y) 和 y.equals(z) 都为 true 时,x.equals(z) 也为 true;
- 一致性:对象没有被修改时,多次调用 x.equals(y) 的结果不变;
- 与 null 的比较:对任何不是 null 的对象 x,x.equals(null) 为 false。
2. 等价与相等
- 对于基本类型,== 判断两个值是否相等,基本类型没有 equals() 方法;
- 对于引用类型,== 判断两个变量是否引用同一个对象,而 equals() 判断引用的对象是否等价。
Integer x = new Integer(1);
Integer y = new Integer(1);
System.out.println(x.equals(y)); // true
System.out.println(x == y);      // false
3. 实现
- 检查是否为同一个对象的引用,如果是直接返回 true;
- 检查是否是同一个类型,如果不是,直接返回 false;
- 将 Object 对象进行转型;
- 判断每个关键域是否相等。
public class EqualExample {

    private int x;
    private int y;
    private int z;

    public EqualExample(int x, int y, int z) {
        this.x = x;
        this.y = y;
        this.z = z;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        EqualExample that = (EqualExample) o;

        if (x != that.x) return false;
        if (y != that.y) return false;
        return z == that.z;
    }
}
hashCode()
hashCode() 返回哈希值,而 equals() 是用来判断两个对象是否等价。Object 规定等价的两个对象哈希值必须相同,但是哈希值相同的两个对象不一定等价,这是因为哈希值只有 32 位,不同的对象可能计算出相同的哈希值,例如 "Aa" 和 "BB" 的哈希值都是 2112(见附录 A2)。
在覆盖 equals() 方法时应当总是覆盖 hashCode() 方法,保证等价的两个对象哈希值也相等。
HashSet 和 HashMap 等集合类使用了 hashCode() 方法来计算对象应该存储的位置,因此要将对象添加到这些集合类中,重写了 equals() 的类也要重写 hashCode(),并且只用参与 equals() 比较的字段计算哈希值。
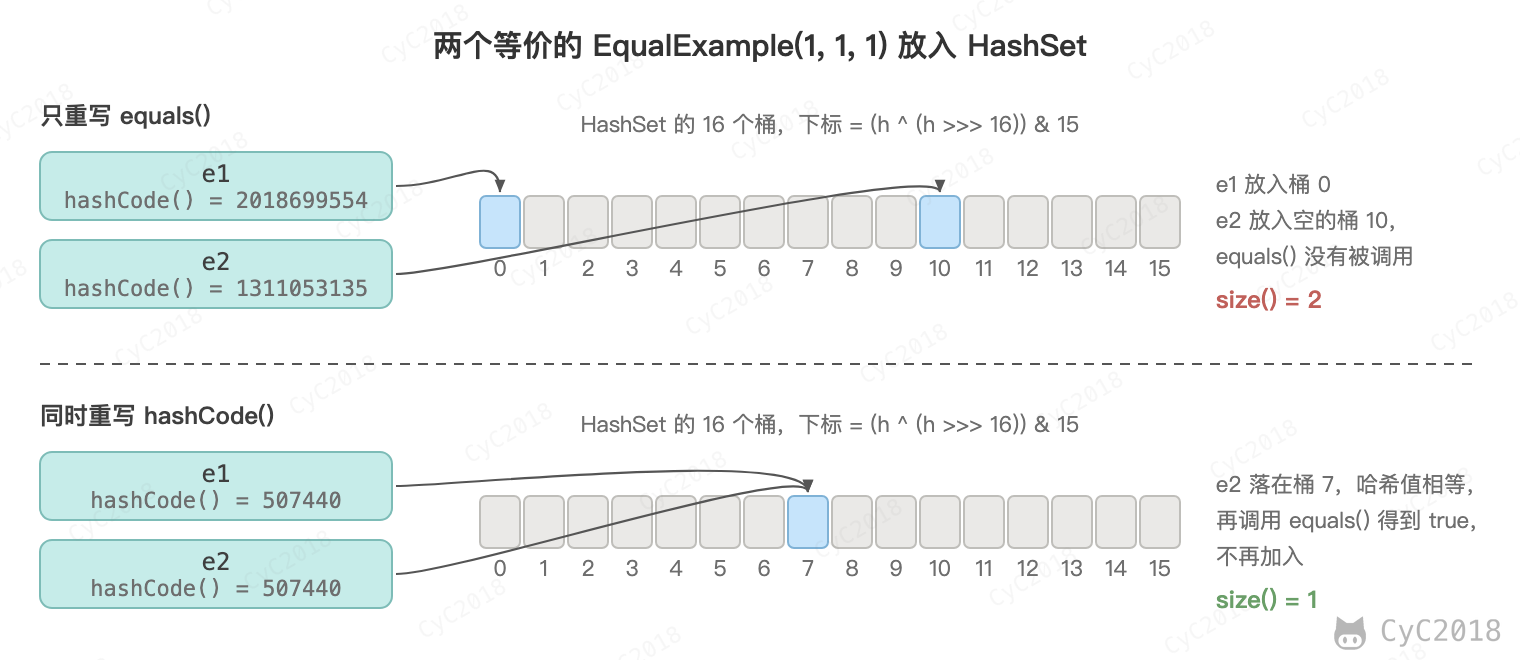
下面的代码中,新建了两个等价的对象,并将它们添加到 HashSet 中。期望的结果是把这两个对象当成一样的,只在集合中添加一个对象。但是 EqualExample 没有重写 hashCode() 方法,使用的是 Object 的实现,两个对象的哈希值通常不同,最终导致集合添加了两个等价的对象。
EqualExample e1 = new EqualExample(1, 1, 1);
EqualExample e2 = new EqualExample(1, 1, 1);
System.out.println(e1.equals(e2)); // true
HashSet<EqualExample> set = new HashSet<>();
set.add(e1);
set.add(e2);
System.out.println(set.size());   // 2
这是因为 HashMap 查找键时先用 hashCode() 确定桶下标,在桶中先比较哈希值,哈希值相等时才用 == 或 equals() 判断。e1 和 e2 的哈希值不同,多半落在不同的桶中,即使落在同一个桶,也会因为哈希值不同而被跳过,equals() 根本没有机会被调用(JDK 21 实测,见附录 A7)。HashSet 内部就是一个 HashMap,元素作为键存放。
重写 hashCode() 后,两个对象落在同一个桶中,equals() 才有机会被调用:
理想的哈希函数应当具有均匀性,即不相等的对象应当均匀分布到所有可能的哈希值上。这就要求哈希函数把参与 equals() 比较的域都考虑进来。可以将每个域都当成 R 进制的某一位,然后组成一个 R 进制的整数。
R 一般取 31,因为它是一个奇素数,如果是偶数的话,当出现乘法溢出,信息就会丢失,因为与 2 相乘相当于向左移一位,最左边的位丢失。并且一个数与 31 相乘可以转换成移位和减法:31*x == (x<<5)-x,虚拟机可以自动进行这个优化。
@Override
public int hashCode() {
    int result = 17;
    result = 31 * result + x;
    result = 31 * result + y;
    result = 31 * result + z;
    return result;
}
实际编写时可以直接调用 Objects.hash(x, y, z),它按同样的方式计算,只是初始值为 1。
JDK 中常见类型的 hashCode() 也很简单:Integer 直接返回值本身,Long 返回高 32 位与低 32 位的异或,String 按 s[0]×31^(n−1) + s[1]×31^(n−2) + … + s[n−1] 计算,算出后保存在 hash 字段中。
没有覆盖时,Object 的 hashCode() 并不是对象的内存地址。HotSpot 在第一次调用时用当前线程的 xorshift 随机数生成器得到一个 31 位的值,写入对象头的 Mark Word(见 对象的创建与内存布局),之后对象即使被 GC 移动,哈希值也不变。生成方式由 -XX:hashCode 选择,JDK 21 的默认值为 5,即上面的随机数方案,改为 2 时所有对象的哈希值都是 1(见附录 A7)。
toString()
默认返回 ToStringExample@4554617c 这种形式,其中 @ 后面的数值为哈希码的无符号十六进制表示。
public class ToStringExample {

    private int number;

    public ToStringExample(int number) {
        this.number = number;
    }
}
ToStringExample example = new ToStringExample(123);
System.out.println(example.toString());
ToStringExample@4554617c
clone()
1. Cloneable
clone() 是 Object 的 protected 方法,它不是 public,一个类不显式去重写 clone(),其它类就不能直接去调用该类实例的 clone() 方法。
public class CloneExample {
    private int a;
    private int b;
}
CloneExample e1 = new CloneExample();
// CloneExample e2 = e1.clone(); // 'clone()' has protected access in 'java.lang.Object'
重写 clone() 得到以下实现:
public class CloneExample {
    private int a;
    private int b;

    @Override
    public CloneExample clone() throws CloneNotSupportedException {
        return (CloneExample)super.clone();
    }
}
CloneExample e1 = new CloneExample();
try {
    CloneExample e2 = e1.clone();
} catch (CloneNotSupportedException e) {
    e.printStackTrace();
}
java.lang.CloneNotSupportedException: CloneExample
以上抛出了 CloneNotSupportedException,这是因为 CloneExample 没有实现 Cloneable 接口。
需要注意的是,clone() 方法并不是 Cloneable 接口的方法,而是 Object 的一个 protected 方法。Cloneable 接口只是规定,如果一个类没有实现 Cloneable 接口又调用了 clone() 方法,就会抛出 CloneNotSupportedException。
public class CloneExample implements Cloneable {
    private int a;
    private int b;

    @Override
    public Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}
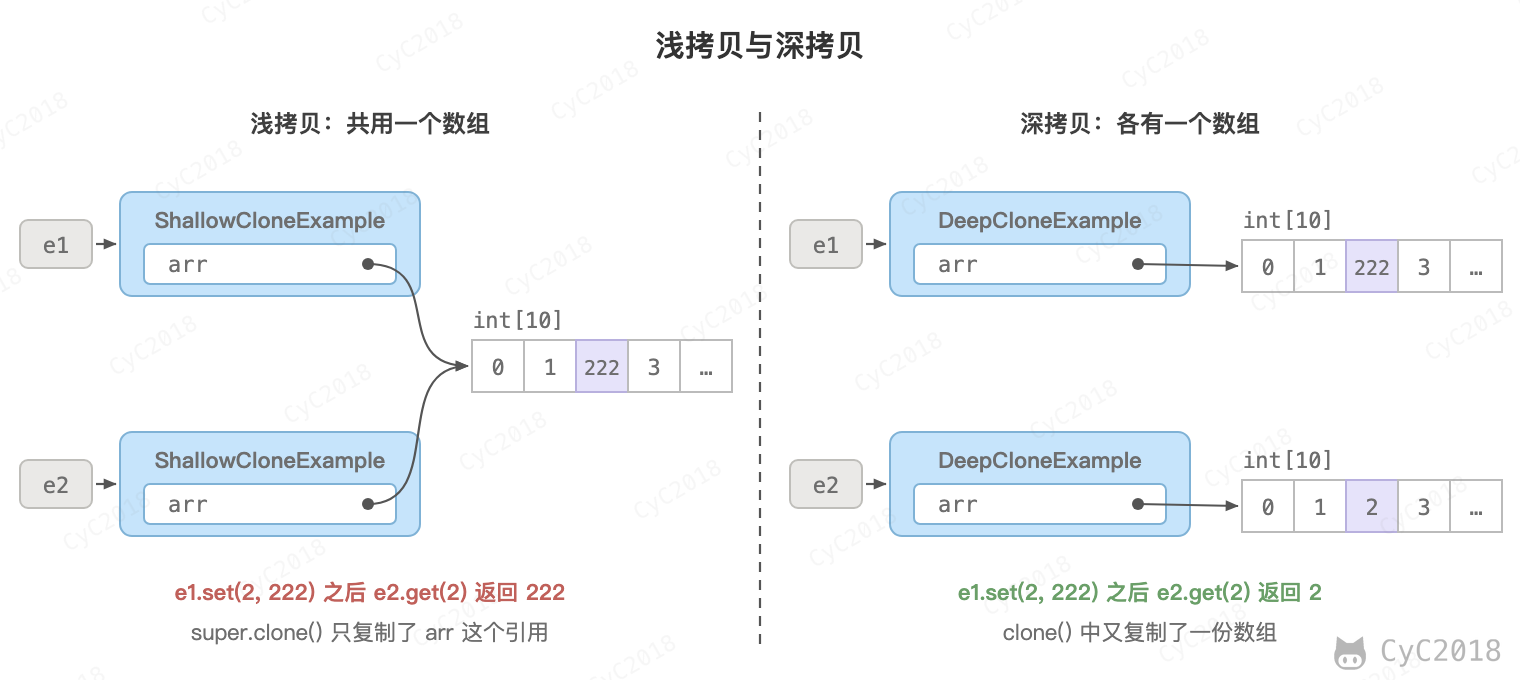
2. 浅拷贝
拷贝对象和原始对象的引用类型引用同一个对象。
public class ShallowCloneExample implements Cloneable {

    private int[] arr;

    public ShallowCloneExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }

    @Override
    protected ShallowCloneExample clone() throws CloneNotSupportedException {
        return (ShallowCloneExample) super.clone();
    }
}
ShallowCloneExample e1 = new ShallowCloneExample();
ShallowCloneExample e2 = null;
try {
    e2 = e1.clone();
} catch (CloneNotSupportedException e) {
    e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 222
3. 深拷贝
拷贝对象和原始对象的引用类型引用不同对象。
public class DeepCloneExample implements Cloneable {

    private int[] arr;  // 构造函数和 set()、get() 同上

    @Override
    protected DeepCloneExample clone() throws CloneNotSupportedException {
        DeepCloneExample result = (DeepCloneExample) super.clone();
        result.arr = new int[arr.length];
        for (int i = 0; i < arr.length; i++) {
            result.arr[i] = arr[i];
        }
        return result;
    }
}
DeepCloneExample e1 = new DeepCloneExample();
DeepCloneExample e2 = null;
try {
    e2 = e1.clone();
} catch (CloneNotSupportedException e) {
    e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 2
引用的对象中还有可变对象时,深拷贝要把对象图中的可变对象都复制一遍,String 这类不可变对象可以共享。例如订单 1024 包含一个 List<Item>:
Order cloneDeep() throws CloneNotSupportedException {
    Order o = (Order) super.clone();   // items 仍指向原来的 List
    o.items = new ArrayList<>(items);  // 新的 List,但元素还是原来的 Item
    o.items.replaceAll(Item::clone);   // 再复制每个 Item,才是深拷贝(Item.clone() 不能声明受检异常)
    return o;
}
逐层 clone 或拷贝构造函数最快,但每层都要手写,新增字段时容易漏掉。序列化后再反序列化不用手写,能处理循环引用,但要求所有类都实现 Serializable,transient 字段不会被复制,而且慢两到三个数量级(JDK 21 粗测,见附录 A8)。
数组的 clone() 是 public 的,不抛受检异常,返回值也不用强制转换,但多维数组只复制最外层,例如 int[][] 复制后的每一行仍与原数组共用(JLS §10.7);new ArrayList<>(list) 和 ArrayList 的 clone() 同样只复制元素的引用(见附录 A8)。
4. clone() 的替代方案
使用 clone() 方法来拷贝一个对象既复杂又有风险,它会抛出异常,并且还需要类型转换。Object.clone() 不调用构造函数,而 final 字段只能在对象初始化时赋值,所以类中有 final 的可变字段(例如 final List)时,不能在 super.clone() 之后给它换一个新对象,这时用拷贝构造函数更合适。Effective Java 书上讲到,最好不要去使用 clone(),可以使用拷贝构造函数或者拷贝工厂来拷贝一个对象。
public class CloneConstructorExample {

    private int[] arr;  // 无参构造函数和 set()、get() 与 ShallowCloneExample 相同

    // 拷贝构造函数
    public CloneConstructorExample(CloneConstructorExample original) {
        arr = new int[original.arr.length];
        for (int i = 0; i < original.arr.length; i++) {
            arr[i] = original.arr[i];
        }
    }
}
CloneConstructorExample e1 = new CloneConstructorExample();
CloneConstructorExample e2 = new CloneConstructorExample(e1);
e1.set(2, 222);
System.out.println(e2.get(2)); // 2
六、继承
访问权限
Java 中有三个访问权限修饰符:private、protected 以及 public,如果不加访问修饰符,表示包级可见。
可以对类或类中的成员(字段和方法)加上访问修饰符。
- 类可见表示其它类可以用这个类创建实例对象;
- 成员可见表示其它类可以用这个类的实例对象访问到该成员。
protected 用于修饰成员,在包外只对子类可见,并且包外的子类只能通过自身类型的引用访问它,不能通过父类类型的引用访问。顶级类不能用 protected 修饰。
四种访问级别的可见范围(JDK 21 编译验证,见附录 A10):
              同一个类   同一个包   不同包的子类   其它包
public           是         是           是          是
protected        是         是           是          否
不加修饰符       是         是           否          否
private          是         否           否          否
设计良好的模块会隐藏所有的实现细节,把它的 API 与它的实现清晰地隔离开来。模块之间只通过它们的 API 进行通信,一个模块不需要知道其他模块的内部工作情况,这个概念被称为信息隐藏或封装。因此访问权限应当尽可能地使每个类或者成员不被外界访问。
如果子类的方法重写了父类的方法,那么子类中该方法的访问级别不允许低于父类的访问级别。这是为了确保可以使用父类实例的地方都可以使用子类实例去代替,也就是确保满足里氏替换原则。
字段决不能是公有的,因为这么做的话就失去了对这个字段修改行为的控制,客户端可以对其随意修改。例如下面的例子中,AccessExample 拥有 id 公有字段,如果在某个时刻想要改为使用 int 存储 id 字段,那么就需要修改所有的客户端代码。
public class AccessExample {
    public String id;
}
可以使用公有的 getter 和 setter 方法来替换公有字段,这样的话就可以控制对字段的修改行为。
public class AccessExample {

    private int id;

    public String getId() {
        return id + "";
    }

    public void setId(String id) {
        this.id = Integer.valueOf(id);
    }
}
但是也有例外,如果是包级私有的类或者私有的嵌套类,那么直接暴露成员不会有特别大的影响。
public class AccessWithInnerClassExample {

    private class InnerClass {
        int x;
    }

    private InnerClass innerClass;

    public AccessWithInnerClassExample() {
        innerClass = new InnerClass();
    }

    public int getValue() {
        return innerClass.x;  // 直接访问
    }
}
抽象类与接口
1. 抽象类
抽象类和抽象方法都使用 abstract 关键字进行声明。如果一个类中包含抽象方法,那么这个类必须声明为抽象类。
抽象类和普通类最大的区别是,抽象类不能被实例化,只能被继承。
public abstract class AbstractClassExample {

    protected int x;
    private int y;

    public abstract void func1();

    public void func2() {
        System.out.println("func2");
    }
}
public class AbstractExtendClassExample extends AbstractClassExample {
    @Override
    public void func1() {
        System.out.println("func1");
    }
}
// AbstractClassExample ac1 = new AbstractClassExample(); // 'AbstractClassExample' is abstract; cannot be instantiated
AbstractClassExample ac2 = new AbstractExtendClassExample();
ac2.func1();
2. 接口
接口是抽象类的延伸,在 Java 8 之前,它可以看成是一个完全抽象的类,也就是说它不能有任何的方法实现。
从 Java 8 开始,接口也可以拥有默认的方法实现,这是因为不支持默认方法的接口的维护成本太高了。在 Java 8 之前,如果一个接口想要添加新的方法,那么要修改所有实现了该接口的类,让它们都实现新增的方法。
接口的成员(字段 + 方法)默认都是 public 的,并且不允许定义为 protected。在 Java 8 及之前也不允许定义为 private,从 Java 9 开始,允许将方法定义为 private,这样就能定义某些复用的代码又不会把方法暴露出去。
接口的字段默认都是 static 和 final 的。
public interface InterfaceExample {

    void func1();

    default void func2(){
        System.out.println("func2");
    }

    int x = 123;
    // int y;               // Variable 'y' might not have been initialized
    public int z = 0;       // Modifier 'public' is redundant for interface fields
    // private int k = 0;   // Modifier 'private' not allowed here
    // protected int l = 0; // Modifier 'protected' not allowed here
    // private void fun3(); // missing method body:Java 9 起可以定义私有方法,但必须有方法体
}
public class InterfaceImplementExample implements InterfaceExample {
    @Override
    public void func1() {
        System.out.println("func1");
    }
}
// InterfaceExample ie1 = new InterfaceExample(); // 'InterfaceExample' is abstract; cannot be instantiated
InterfaceExample ie2 = new InterfaceImplementExample();
ie2.func1();
System.out.println(InterfaceExample.x);
3. 比较
- 从设计层面上看,抽象类提供了一种 IS-A 关系,需要满足里氏替换原则,即子类对象必须能够替换掉所有父类对象。而接口更像是一种 LIKE-A 关系,它只是提供一种方法实现契约,表示实现类具备某种能力,并不要求两者在概念上是同一类事物(从类型上看,实现类仍是接口的子类型);
- 从使用上来看,一个类可以实现多个接口,但是不能继承多个抽象类;
- 接口的字段只能是 static 和 final 类型的,而抽象类的字段没有这种限制;
- 接口的成员默认是 public 的,Java 9 起方法可以是 private 的,但不能是 protected 的;抽象类的成员可以有多种访问权限;
- 抽象类有构造函数,创建子类对象时会调用;接口没有构造函数;
- Java 8 起接口可以有静态方法,只能通过接口名调用,不会被实现类继承;
- 只有接口(函数式接口)能作为 Lambda 的目标类型;记录类和枚举不能继承自定义的类,只能实现接口;接口只能继承接口,不能继承抽象类。
一个类实现的两个接口有签名相同的默认方法时,必须重写该方法,可以用“接口名.super.方法名()”选择一个实现:
interface Pay { default String channel() { return "Pay"; } }
interface Refund { default String channel() { return "Refund"; } }

class Order implements Pay, Refund {
    public String channel() { return Pay.super.channel(); }   // Pay
}
有两种情况不必重写:父类已经实现了这个方法时(例如 Order 继承的父类有 public String channel()),以父类的方法为准;一个接口已经覆盖了另一个接口的默认方法时(例如 FastPay extends Pay 并重写了 channel()),以覆盖后的方法为准(JLS §8.4.8)。
4. 使用选择
使用接口:
- 需要让不相关的类都实现一个方法,例如不相关的类都可以实现 Comparable 接口中的 compareTo() 方法;
- 需要类型的多重继承,即一个类同时属于多个类型。
使用抽象类:
- 需要在几个相关的类中共享代码;
- 需要能控制继承来的成员的访问权限,而不是都为 public;
- 需要继承非静态和非常量字段。
例如接收多家物流公司的回调,步骤都是验签、幂等检查、处理、应答,只有处理的部分不同,适合写成抽象类:父类固定流程、实现共同的步骤,子类只实现处理的部分(模板方法,见设计模式中的用法)。
在很多情况下,接口优先于抽象类。因为接口没有抽象类严格的类层次结构要求,可以灵活地为一个类添加行为。并且从 Java 8 开始,接口也可以有默认的方法实现,使得修改接口的成本也变得很低。
两者也常组合使用:接口定义类型,抽象类提供骨架实现,例如 AbstractList 实现了 List 的大部分方法,实现一个不可修改的列表只需继承它并实现 get() 和 size()。
一个类型只允许固定的几种子类型时,Java 17 起可以用密封接口加记录类,例子见 Java 各版本的新特性。
super
- 访问父类的构造函数:可以使用 super() 函数访问父类的构造函数,从而委托父类完成一些初始化的工作。子类对象创建时一定会先调用父类的构造函数:构造函数的第一句既不是 super(...) 也不是 this(...) 时,编译器自动插入 super(),调用父类的无参构造函数;需要调用父类其它构造函数时就显式写 super(...);
- 访问父类的成员:如果子类重写了父类的某个方法,可以通过使用 super 关键字来引用父类的方法实现。
public class SuperExample {

    protected int x;
    protected int y;

    public SuperExample(int x, int y) {
        this.x = x;
        this.y = y;
    }

    public void func() {
        System.out.println("SuperExample.func()");
    }
}
public class SuperExtendExample extends SuperExample {

    private int z;

    public SuperExtendExample(int x, int y, int z) {
        super(x, y);
        this.z = z;
    }

    @Override
    public void func() {
        super.func();
        System.out.println("SuperExtendExample.func()");
    }
}
SuperExample e = new SuperExtendExample(1, 2, 3);
e.func();
SuperExample.func()
SuperExtendExample.func()
重写与重载
1. 重写(Override)
存在于继承体系中,指子类实现了一个与父类在方法声明上完全相同的一个方法。
为了满足里氏替换原则,重写有以下三个限制:
- 子类方法的访问权限必须大于等于父类方法;
- 子类方法的返回类型必须是父类方法返回类型或为其子类型,基本类型则必须相同;
- 子类方法抛出的受检异常必须是父类方法抛出的异常类型或为其子类型。
上面三个限制无论是否加注解,编译器都会检查。@Override 注解让编译器检查这个方法确实重写了父类的方法,例如方法名或参数类型写错时,没有注解就会悄悄地变成一个新方法。
静态方法不能被重写:子类中签名相同的静态方法只是隐藏了父类的方法,调用哪一个由变量的静态类型决定,加上 @Override 会编译报错。
下面的示例中,SubClass 为 SuperClass 的子类,SubClass 重写了 SuperClass 的 func() 方法。其中:
- 子类方法访问权限为 public,大于父类的 protected;
- 子类的返回类型为 ArrayList<Integer>,是父类返回类型 List<Integer> 的子类;
- 子类抛出的异常类型为 Exception,是父类抛出异常 Throwable 的子类;
- 子类重写方法使用 @Override 注解,从而让编译器检查它确实重写了父类的方法。
class SuperClass {
    protected List<Integer> func() throws Throwable {
        return new ArrayList<>();
    }
}

class SubClass extends SuperClass {
    @Override
    public ArrayList<Integer> func() throws Exception {
        return new ArrayList<>();
    }
}
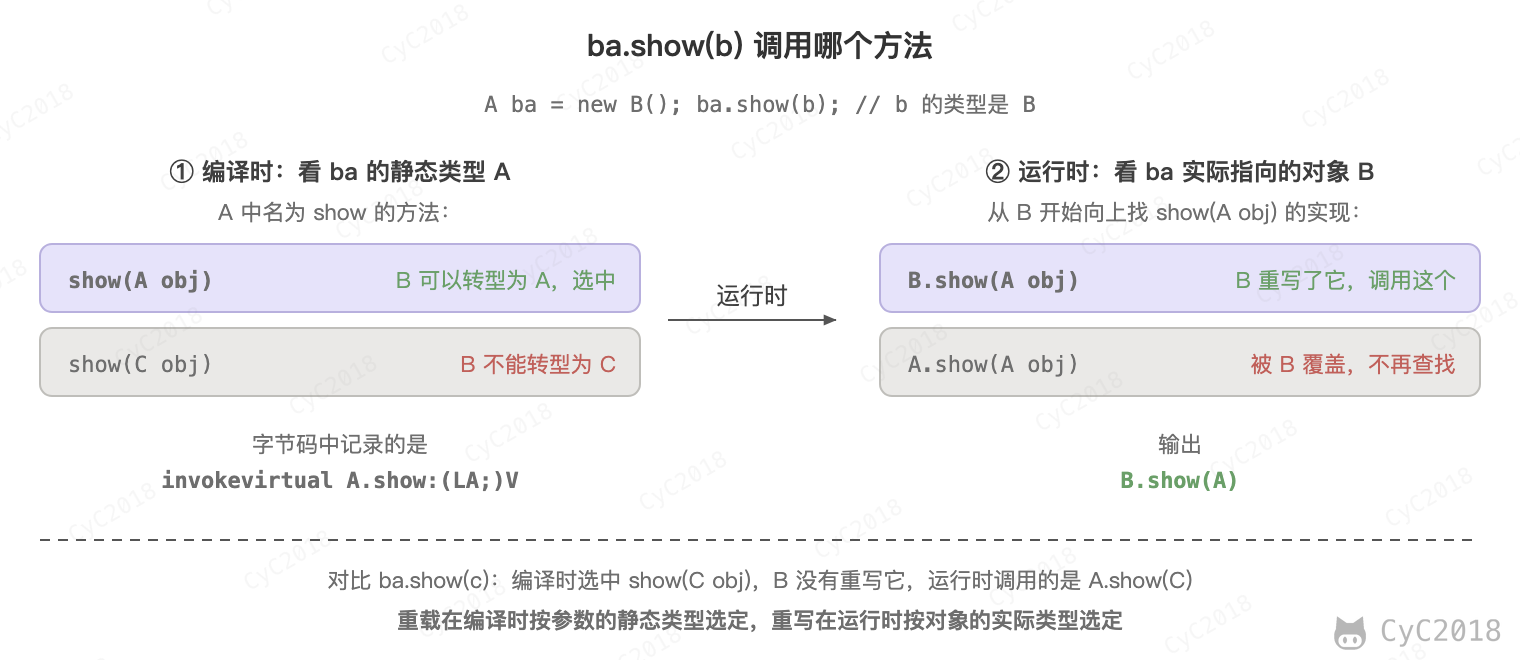
调用一个方法分为两步:
- 编译时,按变量声明的类型(静态类型)找到可以调用的方法,包括从父类继承来的方法,在其中选择参数类型最匹配的一个,参数没有完全匹配的方法时,把参数转型为父类再找;
- 运行时,按对象的实际类型,如果子类重写了编译时选定的方法,就调用子类的版本。
下面的代码中,ba 的静态类型是 A,运行时的对象是 B,ba.show(b) 的两步如下图;ba.show(d) 在编译时选定 show(C obj),B 没有重写它,所以调用的是 A.show(C)。
/*
    A
    |
    B
    |
    C
    |
    D
 */


class A {

    public void show(A obj) {
        System.out.println("A.show(A)");
    }

    public void show(C obj) {
        System.out.println("A.show(C)");
    }
}

class B extends A {

    @Override
    public void show(A obj) {
        System.out.println("B.show(A)");
    }
}

class C extends B {
}

class D extends C {
}
public static void main(String[] args) {

    A a = new A();
    B b = new B();
    C c = new C();
    D d = new D();

    // 在 A 中存在 show(A obj),直接调用
    a.show(a); // A.show(A)
    // 在 A 中不存在 show(B obj),将 B 转型成其父类 A
    a.show(b); // A.show(A)
    // 在 B 中存在从 A 继承来的 show(C obj),直接调用
    b.show(c); // A.show(C)
    // 在 B 中不存在 show(D obj),但是存在从 A 继承来的 show(C obj),将 D 转型成其父类 C
    b.show(d); // A.show(C)

    // 引用的还是 B 对象,所以 ba 和 b 的调用结果一样
    A ba = new B();
    ba.show(b); // B.show(A)
    ba.show(c); // A.show(C)
    ba.show(d); // A.show(C)
}
2. 重载(Overload)
指一个类中(包括从父类继承来的方法)有多个方法名称相同,但是参数类型、个数、顺序至少有一个不同。
需要注意的是,返回值不同,其它都相同不算是重载。
class OverloadingExample {
    public void show(int x) {
        System.out.println(x);
    }

    public void show(int x, String y) {
        System.out.println(x + " " + y);
    }
}
public static void main(String[] args) {
    OverloadingExample example = new OverloadingExample();
    example.show(1);
    example.show(1, "2");
}
重写与重载的区别:重写发生在子类与父类之间,方法的参数列表必须相同,调用哪个版本在运行时按对象的实际类型决定;重载发生在同一个类中(包括继承来的方法),参数列表必须不同,调用哪个版本在编译时按参数的静态类型决定。例如有 show(Object) 和 show(String) 两个重载方法,Object x = "a"; show(x); 调用的是 show(Object),因为 x 的静态类型是 Object(JDK 21 实测)。
七、反射
反射指的是在运行时获取类的信息,并操作它的字段、方法和构造函数。要操作的类可以到运行时才加载(见 类加载过程),编译时它的 .class 文件甚至可以不存在。
每个类都有一个 Class 对象,包含了与类有关的信息。当编译一个新类时,会产生一个同名的 .class 文件,该文件保存着类的字节码,类加载时 JVM 根据它创建对应的 Class 对象。
获取 Class 对象有三种方式:Order.class、order.getClass()、Class.forName("Order"),得到的是同一个对象。其中 forName 默认会初始化这个类,执行它的静态语句块,Order.class 不会(JDK 21 实测,见附录 A9)。
Class 和 java.lang.reflect 一起对反射提供了支持,java.lang.reflect 类库主要包含了以下三个类:
- Field:可以使用 get() 和 set() 方法读取和修改 Field 对象关联的字段;
- Method:可以使用 invoke() 方法调用与 Method 对象关联的方法;
- Constructor:可以用 Constructor 的 newInstance() 创建新的对象。
例如只知道类名 Order 时,创建对象、调用方法并读取私有字段:
Class<?> clazz = Class.forName("Order");
Object order = clazz.getConstructor(long.class).newInstance(1024L);
Method pay = clazz.getMethod("pay", int.class);
System.out.println(pay.invoke(order, 99));     // order 1024 paid 99

Field status = clazz.getDeclaredField("status");
status.setAccessible(true);                    // 私有字段要先关闭访问检查
System.out.println(status.get(order));         // PAID
getMethod()、getField() 只能找到 public 成员,包括继承的;getDeclaredMethod()、getDeclaredField() 能找到本类声明的全部成员,包括私有的,但不含继承的(JDK 21 实测,见附录 A4)。
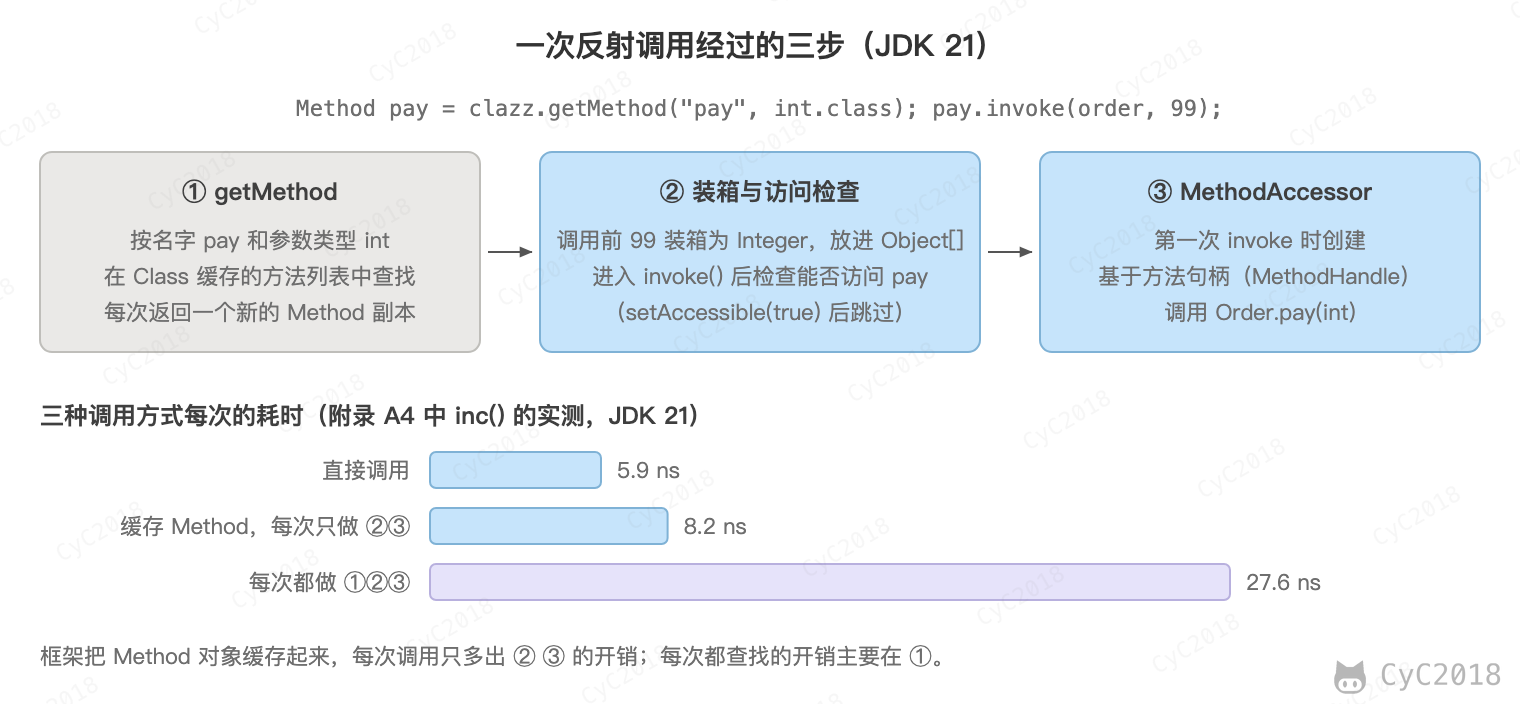
一次反射调用经过的步骤如下图;JDK 17 及之前的 MethodAccessor 不用方法句柄,先用本地方法调用,超过 15 次后再生成一个直接调用目标方法的类。
反射的用途:
- 框架:Spring 按配置或注解中的类名创建 Bean 并注入字段,MyBatis 把查询结果写入对象的字段,JUnit 找出带 @Test 注解的方法逐个调用,这些类在编写框架时都还不存在;
- 动态代理:JDK 动态代理在运行时生成实现了指定接口的类,调用通过 Method 对象转发,见 动态代理;
- 开发工具:IDE 列出类的成员,调试器查看对象的私有字段。
反射的缺点:
- 性能开销:反射调用要检查访问权限、把参数装进 Object 数组,查找 Method 对象的开销更大。JDK 21 上把 Method 对象缓存起来时,每次调用只比直接调用多 2 纳秒左右;每次都用 getMethod() 查找再调用则约 28 纳秒(见附录 A4),所以框架都会缓存 Method 对象;
- 访问限制:JDK 16 起默认禁止类路径上的代码反射访问 JDK 内部的私有成员,例如在 JDK 21 上对 String 的 value 字段调用 setAccessible(true) 会抛出 InaccessibleObjectException,需要启动时加 --add-opens;
- 失去编译期检查:类名和方法名写成字符串,写错或改名后到运行时才抛出 ClassNotFoundException、NoSuchMethodException;
- 破坏封装:反射可以访问私有的字段和方法,依赖这些内部细节的代码在类的实现改变后可能失效。例如调用私有构造函数可以创建出第二个单例对象,见单例的枚举实现;
- 修改 final 字段:setAccessible(true) 之后,Field.set() 也只能修改非 static、所在类不是 record 或 hidden 类的 final 字段;用常量表达式初始化的基本类型或 String 类型的 final 字段(例如 final int a = 1)是常量变量,直接读取它的代码在编译时就内联了它的值,反射把 a 改为 10 后 getA() 仍返回 1(JDK 21 实测,见附录 A4),JDK 26 起这类修改默认会给出警告,以后的版本计划默认禁止(JEP 500)。
八、异常
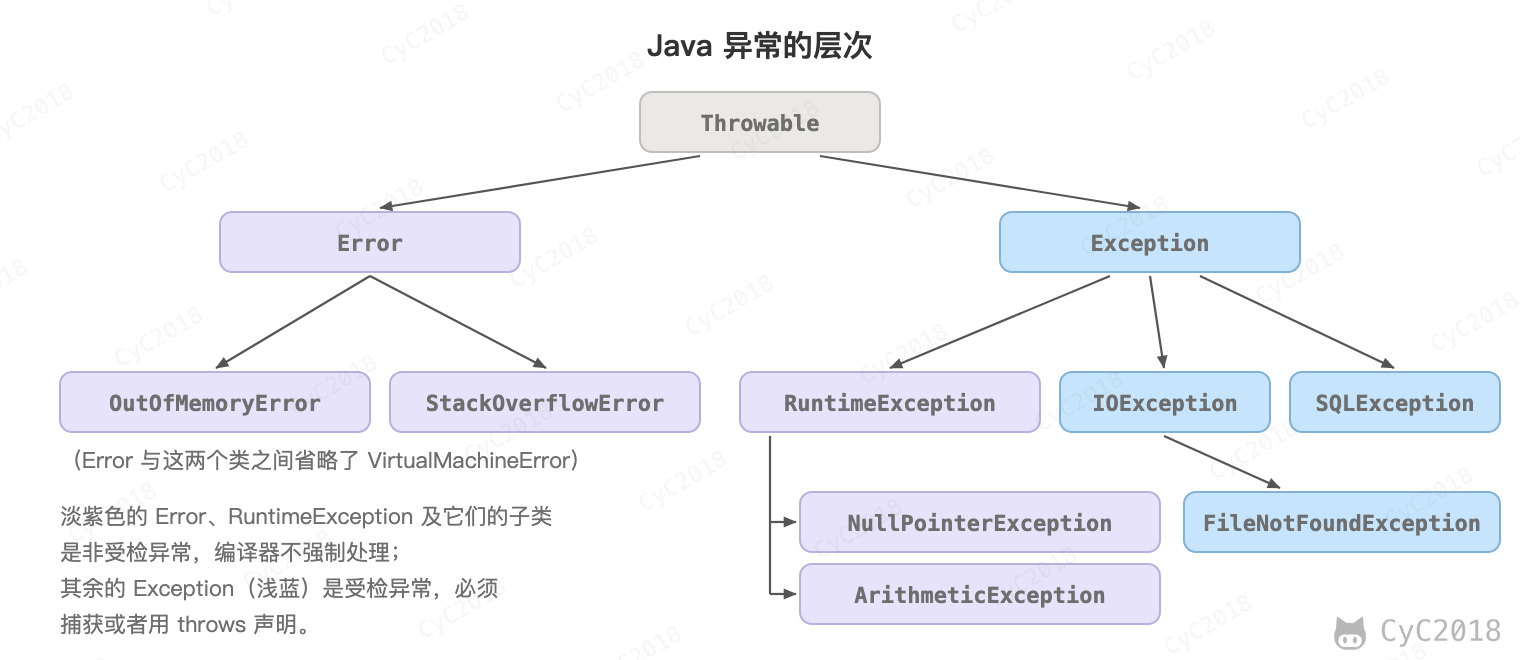
Throwable 可以用来表示任何可以作为异常抛出的类,分为两种:Error 和 Exception。其中 Error 表示严重的问题,例如 OutOfMemoryError、StackOverflowError,它也是 Throwable 的子类,语法上可以捕获,但 Javadoc 说明一般的应用不应尝试捕获它,编译器也不要求捕获或声明。Exception 分为两种:
- 受检异常:例如 IOException、SQLException,需要用 try...catch... 语句捕获并进行处理,或者用 throws 声明抛出,否则编译不通过,这类异常通常可以恢复;
- 非受检异常:RuntimeException 及其子类(按 JLS §11.1.1,Error 及其子类也属于非受检异常),是程序运行时错误,例如除 0 会引发 ArithmeticException,访问 null 的成员会引发 NullPointerException。编译器不强制处理这类异常,通常应该修改代码来避免,而不是捕获之后恢复。
finally 块无论是否发生异常、try 或 catch 中是否执行了 return,都会在离开 try 语句之前执行,通常用来释放锁、关闭资源。finally 与 final、finalize() 只是名字相近:final 是修饰符,见 final;finalize() 是 Object 的方法,对象被回收前可能被调用,JDK 9 起已经废弃,见 finalize()。
try、catch、finally 的执行顺序和返回值有以下规则(JDK 21 实测,见附录 A6):
- try 中发生异常时,跳过 try 中剩下的语句,执行匹配的 catch,再执行 finally;catch 中有 return 时,先计算返回值,执行完 finally 再返回;
- 返回值在执行 finally 之前就已经保存:返回基本类型时,finally 修改这个变量不影响返回值;返回引用时保存的是引用,finally 修改它指向的对象,调用方能看到修改;
- finally 中的 return 会覆盖 try、catch 中的返回值,还会吞掉 try 中抛出的异常,用 -Xlint:finally 编译时会给出警告,不应该这样写;
- finally 不执行的情况:执行到 finally 之前调用了 System.exit()、进程被 kill -9 或 JVM 崩溃。JVM 因 System.exit() 或 kill(SIGTERM)退出时,先运行关闭钩子,钩子运行完 JVM 就终止,其它仍在运行的线程不论是否为守护线程,都不保证执行到 finally;最后一个非守护线程结束、JVM 正常退出时,仍在运行的守护线程同样不保证执行到 finally(JDK 21 实测,见附录 A6)。
static int primitive() {
    int x = 1;
    try {
        return x;            // 返回值 1 先被保存起来
    } finally {
        x = 2;               // 修改的是局部变量 x,返回 1
    }
}

static List<String> reference() {
    List<String> list = new ArrayList<>();
    try {
        list.add("try");
        return list;         // 保存的是引用
    } finally {
        list.add("finally"); // 修改的是同一个对象,返回 [try, finally]
    }
}
编译器把 finally 中的代码复制到 try 和每个 catch 的出口处。return x 编译后先把 x 的值复制到另一个局部变量槽,再执行复制过来的 finally 代码,最后从那个槽中取出值返回,所以 finally 修改 x 不影响返回值。
九、泛型
泛型把类型作为参数,让编译器在编译时检查类型。例如 List<String> 中只能放入字符串,取出时也不需要强制类型转换:
public class Box<T> {
    // T stands for "Type"
    private T t;
    public void set(T t) { this.t = t; }
    public T get() { return t; }
}
Java 的泛型通过类型擦除实现:类型参数只在编译时检查,编译后都替换为它的上界(没有声明上界时为 Object),在取出元素的地方由编译器插入强制类型转换。所以 List<String> 和 List<Integer> 在运行时是同一个类。这样设计主要是为了兼容已有的代码(JLS §4.7):java.util 中的集合直接加上泛型,没有用泛型的旧代码不用修改就能继续调用,各个库也可以分别、逐步地改用泛型。
需要注意的是,类、字段和方法声明中的泛型信息仍然以 Signature 属性保存在 class 文件中,可以通过反射读取(例如 getGenericSuperclass()),被擦除的是对象实例和局部变量上的类型参数:
List<String> a = new ArrayList<>();
List<Integer> b = new ArrayList<>();
System.out.println(a.getClass() == b.getClass());   // true

a.add("redis");
String s = a.get(0);    // 编译为 List.get,返回 Object,再执行 checkcast String
类型擦除带来以下限制:
- 类型参数不能是基本类型,只能写 List<Integer>,不能写 List<int>;
- 不能 new T(),也不能用 instanceof List<String> 判断,因为运行时已经没有 T 和 String 这些信息;
- 类型检查只发生在编译时:把 List<String> 赋值给原始类型 List 后,可以放入一个 Integer,编译器只给出警告,等到取出赋给 String 时才抛出 ClassCastException;通过反射调用 add() 也能绕过检查(见附录 A3)。
通配符用于方法参数,让方法接受一族泛型类型:List<? extends Number> 可以接收 List<Integer>、List<Double>,取出的元素都可以当作 Number,但不能放入 Integer,因为它实际指向的可能是 List<Double>;List<? super Integer> 可以接收 List<Number>、List<Object>,可以放入 Integer,取出的元素只能当作 Object。例如 Collections.copy() 的声明为:
public static <T> void copy(List<? super T> dest, List<? extends T> src)
src 只读取,用 extends;dest 只写入,用 super。
十、注解
Java 注解是附加在代码中的一些元信息,本身不会改变代码的逻辑,要由编译器、注解处理器或者框架读取之后才起作用。@Retention 决定注解保留到什么阶段:
- SOURCE:只在源码中,编译后丢弃,例如 @Override 只给编译器检查用,Lombok 的注解在编译时由注解处理器读取并生成代码;
- CLASS:保留在 class 文件中,但运行时读取不到,这是默认值;
- RUNTIME:运行时可以通过反射读取,Spring 的 @Autowired、@Transactional 都是这一类。
例如定义一个限流注解,再通过反射读出它的值:
@Retention(RetentionPolicy.RUNTIME)
@Target(ElementType.METHOD)
@interface RateLimit {
    int value();                 // 每秒最多请求数
}

class OrderController {
    @RateLimit(100)
    public String create() { return "ok"; }
}

Method m = OrderController.class.getMethod("create");
RateLimit limit = m.getAnnotation(RateLimit.class);
System.out.println(limit.value());   // 100
注解是一种特殊的接口,getAnnotation() 返回的是 JDK 在运行时生成的动态代理对象(类名为 $Proxy1 这样的形式),调用 value() 时从注解的属性表中取值。框架就是这样在调用方法前读出注解,再执行限流、开启事务等逻辑。
十一、特性
Java 各版本的新特性
长期支持(LTS)版本有 8、11、17、21、25,面试中最常问 Java 8 和 Java 21:
| 版本 | 与上一个长期支持版本相比的主要新特性 |
|---|---|
| Java 8(2014) | Lambda 表达式、Stream、Optional、新的日期时间 API(java.time)、接口默认方法;永久代被元空间取代 |
| Java 11(2018) | 模块系统(Java 9 引入)、var 用于 Lambda 参数(var 本身在 Java 10 引入)、G1 成为默认的垃圾收集器(Java 9 引入)、标准化的 HttpClient、String 新增 isBlank、strip、repeat 等方法 |
| Java 17(2021) | 记录类(record)、密封类(sealed)、文本块、instanceof 模式匹配、新的 switch 表达式 |
| Java 21(2023) | 虚拟线程、switch 模式匹配、记录模式、有序集合接口 SequencedCollection |
| Java 25(2025) | 作用域值(ScopedValue)、紧凑源文件与实例 main 方法、灵活的构造函数体;虚拟线程在 synchronized 中阻塞时基本不再固定在平台线程上(JDK 24 起) |
以下代码在 JDK 21 上编译运行,用到了其中的大部分特性:
sealed interface Shape permits Circle, Square {}
record Circle(double r) implements Shape {}
record Square(double side) implements Shape {}

static double area(Shape s) {
    return switch (s) {                          // switch 模式匹配,编译器检查是否覆盖了所有子类
        case Circle c -> Math.PI * c.r() * c.r();
        case Square(double side) -> side * side; // 记录模式,直接取出字段
    };
}

var upper = List.of("redis", "mysql", "kafka", "java").stream()
        .filter(w -> w.length() == 5)
        .map(String::toUpperCase)
        .collect(Collectors.toList());           // [REDIS, MYSQL, KAFKA]

Thread.ofVirtual().start(() -> System.out.println(Thread.currentThread().isVirtual()));  // true
虚拟线程是 JVM 实现的协程,执行大多数阻塞 I/O 时会从平台线程上卸载,让平台线程去执行其它虚拟线程,适合大量请求都在等待 I/O 的场景,对 CPU 密集的任务没有帮助,见协程。
Lambda 表达式不会生成匿名内部类的 class 文件。Lambda 的方法体被编译成当前类的私有方法 lambda$main$0(没有用到 this 时是静态方法),调用处是一条 invokedynamic 指令,第一次执行时由 LambdaMetafactory 在运行时生成实现函数式接口的类(javap 实测,见附录 A5)。
Lambda 中用到的外部局部变量必须是 final 或者赋值后没有再被修改过(effectively final),这是因为 Lambda 捕获的是变量的值,而不是变量本身。
常用的中间操作中,filter 按条件保留元素,map 把每个元素变成另一个元素,flatMap 把每个元素变成一个流,再把这些流连接成一个流,常用于展开嵌套的集合:
List<List<String>> groups = List.of(List.of("redis", "mysql"), List.of("kafka"));
groups.stream().map(List::size).toList();          // [2, 1]
groups.stream().flatMap(List::stream).toList();    // [redis, mysql, kafka]
Stream 是惰性求值的:filter、map 等中间操作只是记录下来,遇到 collect、findFirst 等终止操作才开始执行,并且每个元素依次走完整条流水线(sorted 要先收齐全部元素,是例外)。求 upper 的例子改为 findFirst() 时,只处理了第一个元素 redis 就返回了,后面的 mysql、kafka 都没有被处理。
Java 与 C++ 的区别
- Java 的代码都写在类中,除了基本类型之外,所有的对象都继承自 java.lang.Object;C++ 为了兼容 C,既支持面向对象也支持面向过程;
- Java 通过虚拟机从而实现跨平台特性,但是 C++ 依赖于特定的平台;
- Java 没有指针,它的引用可以理解为安全指针,而 C++ 具有和 C 一样的指针;
- Java 支持自动垃圾收集,而 C++ 需要手动释放内存;
- Java 不支持多重继承,只能通过实现多个接口来达到相同目的,而 C++ 支持多重继承;
- Java 不支持操作符重载,虽然可以对两个 String 对象执行加法运算,但是这是语言内置支持的操作,不属于操作符重载,而 C++ 可以;
- Java 的 goto 是保留字,但是不可用,C++ 可以使用 goto。
与 Go、Python 相比:
| Java | Go | Python(CPython) | |
|---|---|---|---|
| 执行方式 | 编译为字节码,由 JVM 解释执行,热点代码由 JIT 编译为机器码 | 直接编译为机器码,生成一个可执行文件,启动快 | 编译为字节码,由解释器执行,3.13 起有实验性的 JIT |
| 类型检查 | 静态类型,编译时检查 | 静态类型,编译时检查 | 动态类型,运行时才发现类型错误 |
| 并发 | 线程对应操作系统线程,JDK 21 起有虚拟线程 | goroutine 由运行时调度到少量线程上,用 channel 通信 | 有全局解释器锁(GIL),同一时刻只有一个线程执行 Python 代码,CPU 密集型任务要用多进程;3.13 起提供去掉 GIL 的版本,3.14 起正式支持,但不是默认版本 |
| 内存回收 | 分代的垃圾收集器,可以选择 G1、ZGC 等 | 与程序并发执行的标记清除,不移动对象 | 以引用计数为主,计数为 0 时立即释放,再用垃圾收集器处理循环引用 |
| 错误处理 | 异常 | 函数返回 error 值,由调用方检查 | 异常 |
JRE or JDK
- JRE:Java Runtime Environment,Java 运行环境的简称,为 Java 的运行提供了所需的环境,主要包括 JVM 和 Java 基本类库;
- JDK:Java Development Kit,Java 开发工具包,提供了 Java 的开发及运行环境。JDK 是 Java 开发的核心,集成了 JRE 以及一些其它的工具,比如编译 Java 源码的编译器 javac 等。
JDK 11 起 Oracle 不再单独发布 JRE,需要精简的运行环境时,可以用 jlink 生成只包含程序所需模块的运行时。
附录:实测
以下实验的环境为 Apple M1 Pro、macOS,JDK 为 Adoptium OpenJDK 21.0.13。
A1 包装类型的缓存池
Integer a = 127, b = 127, c = 128, d = 128;
System.out.println("Integer 127: " + (a == b) + ",128: " + (c == d));
Long e = 127L, f = 127L, g = 128L, h = 128L;
System.out.println("Long 127: " + (e == f) + ",128: " + (g == h));
Character i = 127, j = 127, k = 128, l = 128;
System.out.println("Character 127: " + (i == j) + ",128: " + (k == l));
Short s1 = 127, s2 = 127, s3 = 128, s4 = 128;
System.out.println("Short 127: " + (s1 == s2) + ",128: " + (s3 == s4));
Byte b1 = -128, b2 = -128;
Boolean t1 = true, t2 = true;
System.out.println("Byte -128: " + (b1 == b2) + ",Boolean true: " + (t1 == t2));
Float f1 = 1.0f, f2 = 1.0f;
System.out.println("Float 1.0: " + (f1 == f2));
Double m = 1.0, n = 1.0;
System.out.println("Double 1.0: " + (m == n));
Integer x = new Integer(123), y = new Integer(123);
System.out.println("new Integer(123) == new Integer(123): " + (x == y));
$ javac Cache.java
Cache.java:18: 警告: [removal] Integer 中的 Integer(int) 已过时, 且标记为待删除
$ java Cache
Integer 127: true,128: false
Long 127: true,128: false
Character 127: true,128: false
Short 127: true,128: false
Byte -128: true,Boolean true: true
Float 1.0: false
Double 1.0: false
new Integer(123) == new Integer(123): false
$ java -XX:AutoBoxCacheMax=1000 Cache
Integer 127: true,128: true
A2 字符串的存储
value 和 coder 是 String 的私有字段,用反射读取,运行时需要加上 --add-opens java.base/java.lang=ALL-UNNAMED:
String s1 = "abc";
String s2 = "abc";
String s3 = new String("abc");
Field value = String.class.getDeclaredField("value");
value.setAccessible(true);
byte[] v1 = (byte[]) value.get(s1), v3 = (byte[]) value.get(s3);
System.out.println("s1.value == s3.value: " + (v1 == v3));
s1 == s2: true
s1 == s3: false
s3.intern() == s1: true
s1.value == s3.value: true,内容 [97, 98, 99],coder 0
"中" 的 coder: 1,value 长度 2
"Aa".hashCode() = 2112,"BB".hashCode() = 2112
intern() 的返回值:
String a = new String("order") + new String("1024");
System.out.println("a.intern() == a: " + (a.intern() == a));
String b = new String("ja") + new String("va");   // 池中已经有 "java"(JDK 自带的 CDS 归档中就有)
System.out.println("b.intern() == b: " + (b.intern() == b));
a.intern() == a: true
b.intern() == b: false
编译期常量的拼接(正文中的例子,另加一个方法返回值 id() 参与的拼接),以及 new String("1") + new String("1") 的 intern():
String x = new String("1") + new String("1");
System.out.println("x.intern() == x: " + (x.intern() == x));
$ javac StrTest.java && java StrTest(节选)
"order" + "1024" == s: true
final 变量 + "1024" == s: true
非 final 变量 + "1024" == s: false
"order" + id() == s: false
s + "" == s: false
x.intern() == x: false
$ java -Xshare:off StrTest(节选)
x.intern() == x: true
对 String 使用 switch(正文中 case "a"、case "b" 的例子)编译后的字节码:
$ javap -c SwExpr(节选)
       5: invokevirtual #7                  // Method java/lang/String.hashCode:()I
       8: lookupswitch  { // 2
      39: invokevirtual #15                 // Method java/lang/String.equals:(Ljava/lang/Object;)Z
      53: invokevirtual #15                 // Method java/lang/String.equals:(Ljava/lang/Object;)Z
紧凑字符串节省的空间:用 JOL 0.17 统计 "a".repeat(n) 的深大小(String 对象加 byte 数组,压缩指针开启),与 -XX:-CompactStrings 对比:
String s = "a".repeat(n);
System.out.println(n + " 个字符: " + GraphLayout.parseInstance(s).totalSize() + " 字节");
                 1 个字符  12 个字符  100 个字符  1000 个字符
默认                   48         56         144         1040
-CompactStrings        48         64         240         2040
a + "-" + b 编译后的字节码,以及循环拼接 10000 次的分配量(ThreadMXBean.getCurrentThreadAllocatedBytes(),取预热后的第 3 轮):
static String plus(int n) { String s = ""; for (int i = 0; i < n; i++) s += "x"; return s; }
static String sb(int n) { StringBuilder b = new StringBuilder(); for (int i = 0; i < n; i++) b.append("x"); return b.toString(); }
$ javac Cat.java && javap -c Cat(节选)
       2: invokedynamic #7,  0              // InvokeDynamic #0:makeConcatWithConstants:(Ljava/lang/String;Ljava/lang/String;)Ljava/lang/String;
$ javac --release 8 -d r8 Cat.java && javap -c r8/Cat.class(节选)
       0: new           #7                  // class java/lang/StringBuilder
       8: invokevirtual #10                 // Method java/lang/StringBuilder.append:(Ljava/lang/String;)Ljava/lang/StringBuilder;
$ java Loop
n = 10000,+= 分配 50440768 字节,StringBuilder 分配 47880 字节
A3 泛型的类型擦除
List<String> a = new ArrayList<>();
List<Integer> b = new ArrayList<>();
System.out.println("a.getClass() == b.getClass(): " + (a.getClass() == b.getClass()));
a.add("redis");
String s = a.get(0);
List raw = a;                // 原始类型,编译时只有警告
raw.add(1024);
System.out.println("a = " + a);
String t = a.get(1);         // 抛出 ClassCastException
List.class.getMethod("add", Object.class).invoke(b, "kafka");
System.out.println("b = " + b);
Note: Erase.java uses unchecked or unsafe operations.
a.getClass() == b.getClass(): true
a = [redis, 1024]
ClassCastException: class java.lang.Integer cannot be cast to class java.lang.String
b = [kafka]
$ javap -c Erase(节选)
      58: invokeinterface #39,  2           // InterfaceMethod java/util/List.get:(I)Ljava/lang/Object;
      63: checkcast     #43                 // class java/lang/String
A4 反射与注解
正文中反射和注解的两段代码运行结果:
order 1024 paid 99
PAID
InaccessibleObjectException: Unable to make field private final byte[] java.lang.String.value accessible: module java.base does not "opens java.lang" to unnamed module @76ed5528
100
$Proxy1 implements RateLimit
getMethod() 与 getDeclaredMethod() 的查找范围:Order 继承 Base,Base 有 public 方法 hello(),Order 有私有方法 audit(String):
getMethod("hello")                -> public void Base.hello()
getMethod("audit", String.class)  -> NoSuchMethodException: Order.audit(java.lang.String)
getDeclaredMethod("hello")        -> NoSuchMethodException: Order.hello()
未 setAccessible 时 invoke audit  -> IllegalAccessException
setAccessible(true) 后 invoke     -> audited by tom
反射调用的耗时:inc() 对一个 volatile 字段加 1(volatile 防止 JIT 把整个循环优化掉),每轮直接调用和 Method.invoke 各 5000 万次,每次 getMethod 再调用 100 万次:
for (int i = 0; i < N; i++) o.inc(1);
for (int i = 0; i < N; i++) m.invoke(o, 1);
for (int i = 0; i < N / 50; i++) ReflBench.class.getMethod("inc", int.class).invoke(o, 1);
round 0: 直接调用 5.91 ns,Method.invoke 8.32 ns,每次 getMethod 再 invoke 43.0 ns
round 1: 直接调用 5.60 ns,Method.invoke 8.13 ns,每次 getMethod 再 invoke 27.5 ns
round 2: 直接调用 5.90 ns,Method.invoke 8.19 ns,每次 getMethod 再 invoke 30.7 ns
round 3: 直接调用 5.90 ns,Method.invoke 8.18 ns,每次 getMethod 再 invoke 27.5 ns
round 4: 直接调用 5.91 ns,Method.invoke 8.15 ns,每次 getMethod 再 invoke 27.6 ns
用反射修改 final 字段:
static class Order {
    final int a = 1;                 // 常量变量,读取处被内联
    final Integer b = 2;             // Integer 类型,b 不是常量变量
    static final Integer C = 3;
    int getA() { return a; }
    Integer getB() { return b; }
}
record Point(int x) {}

Field fa = Order.class.getDeclaredField("a"); fa.setAccessible(true); fa.setInt(o, 10);
Field fb = Order.class.getDeclaredField("b"); fb.setAccessible(true); fb.set(o, 20);
// 再分别对 static final 的 C 和 record 的 x 调用 set
a: getA() = 1, 反射读取 = 10
b: getB() = 20, 反射读取 = 20
static final: IllegalAccessException
record: IllegalAccessException
A5 Lambda 与 Stream
Optional<String> first = List.of("redis", "mysql", "kafka", "java").stream()
        .peek(w -> System.out.println("处理 " + w))
        .filter(w -> w.length() == 5)
        .map(String::toUpperCase)
        .findFirst();
System.out.println(first.get());
处理 redis
REDIS
$ ls Lam*.class
Lam.class
$ javap -c -p Lam(节选)
      16: invokedynamic #25,  0             // InvokeDynamic #0:accept:()Ljava/util/function/Consumer;
      26: invokedynamic #35,  0             // InvokeDynamic #1:test:()Ljava/util/function/Predicate;
  private static boolean lambda$main$1(java.lang.String);
  private static void lambda$main$0(java.lang.String);
正文中 map 与 flatMap 的例子:
[2, 1]
[redis, mysql, kafka]
A6 finally 的执行顺序与返回值
正文中的 primitive() 和 reference(),以及以下几个方法:
static int pay() {
    try {
        System.out.println("try");
        Integer.parseInt("x");          // 抛出 NumberFormatException
        return 1;
    } catch (NumberFormatException e) {
        System.out.println("catch");
        return 2;
    } finally {
        System.out.println("finally");
    }
}

static int override() {
    try {
        throw new IllegalStateException("库存不足");
    } finally {
        return -1;                      // 覆盖了异常
    }
}

// main 中
try {
    System.out.println("try");
    System.exit(0);
} finally {
    System.out.println("finally");
}
$ javac -Xlint:finally Fin.java
Fin.java:28: 警告: [finally] finally 子句无法正常完成
$ java Order
try
catch
finally
返回 2
$ java Fin
primitive(): 1
reference(): [try, finally]
override(): -1
try
$ javap -c -p Fin(primitive() 节选)
       0: iconst_1
       1: istore_0
       2: iload_0
       3: istore_1
       4: iconst_2
       5: istore_0
       6: iload_1
       7: ireturn
       8: astore_2
       9: iconst_2
      10: istore_0
      11: aload_2
      12: athrow
System.exit(0) 之后的 finally 没有输出。字节码中,0~7 是正常返回的路径:x = 1 存入槽 0,返回值复制到槽 1,执行 finally 中的 x = 2,再返回槽 1 中的 1;8~12 是发生异常时的路径,其中 9~10 是同一段 finally 代码的另一份副本。
其它线程中的 finally:主线程启动一个非守护线程和一个守护线程,两者都 sleep 60 秒并带有 finally,再注册一个打印“关闭钩子”的关闭钩子,然后分别调用 System.exit(0) 和用 kill 发送 SIGTERM:
$ java F exit
调用 System.exit(0)
关闭钩子
$ java F & sleep 1.5; kill $!
main 结束,等待 kill
关闭钩子
两个线程的 finally 都没有执行。
A7 hashCode 的生成与比较顺序
Object a = new Object(), b = new Object();
System.out.println(a.hashCode() + " " + b.hashCode() + " " + a.hashCode());
$ java Hash
1829164700 2018699554 1829164700
$ java -XX:+UnlockExperimentalVMOptions -XX:hashCode=2 Hash
1 1 1
$ java -XX:+UnlockExperimentalVMOptions -XX:+PrintFlagsFinal -version | grep -w hashCode
     intx hashCode                                 = 5                                    {experimental} {default}
Key 的 hashCode() 返回 id,hashCode() 和 equals() 被调用时打印一行。容量为 16 时,id 为 1 和 17 的键落在同一个桶中:
Map<Key, String> map = new HashMap<>();
map.put(new Key(1), "a");
map.get(new Key(1));
map.get(new Key(17));
put(new Key(1))
  hashCode 被调用
get(new Key(1))
  hashCode 被调用
  equals 被调用
  结果 a
get(new Key(17))
  hashCode 被调用
  结果 null
两个 EqualExample(1, 1, 1) 放入 HashSet,桶下标按 HashMap 的方式 (h ^ (h >>> 16)) & 15 计算:
只重写 equals():     e1 2018699554 桶 0,e2 1311053135 桶 10,size 2
同时重写 hashCode(): e1 507440 桶 7,e2 507440 桶 7,add(e2) 返回 false,size 1
A8 深拷贝的几种方式
Order 包含 List<Item>,分别用 super.clone()、只复制 List、逐层 clone、序列化后反序列化得到 4 个副本,再把原订单中 Item 的数量从 1 改为 2:
Order shallow = o.shallowClone();   // 只调用 super.clone()
Order one = o.cloneOneLevel();      // super.clone() 后 new ArrayList<>(items)
Order deep = o.cloneDeep();         // 正文中的代码
Order ser = bySerialization(o);     // ObjectOutputStream 写出再读回
o.items.get(0).count = 2;
原订单       [宫保鸡丁x2]
super.clone  [宫保鸡丁x2]  共用 List: true
只复制 List  [宫保鸡丁x2]
逐层 clone   [宫保鸡丁x1]
序列化       [宫保鸡丁x1]
第 1 轮:逐层 clone 77 ns/次,序列化 16123 ns/次
第 2 轮:逐层 clone 15 ns/次,序列化 10193 ns/次
第 3 轮:逐层 clone 19 ns/次,序列化 6866 ns/次
耗时为循环 20 万次(序列化 1 万次)的平均值,机器上同时有其它任务,只用来比较数量级;第 1 轮包含解释执行和 JIT 编译的时间,后两轮更接近稳定后的耗时。
数组和 ArrayList 的复制:
int[][] grid = {{1, 2}, {3, 4}};
int[][] copy = grid.clone();              // 不用 try/catch,也不用强制转换
copy[0][0] = 9;
List<int[]> list = new ArrayList<>(List.of(new int[]{1}));
List<int[]> l2 = new ArrayList<>(list);
grid[0][0] = 9,copy[0] == grid[0]: true
new ArrayList<>(list) 的元素相同: true
final 字段不能在 clone() 中重新赋值:
class Cart implements Cloneable {
    private final List<String> items = new ArrayList<>();
    @Override public Cart clone() {
        try {
            Cart c = (Cart) super.clone();
            c.items = new ArrayList<>(items);
            return c;
        } catch (CloneNotSupportedException e) { throw new AssertionError(e); }
    }
}
$ javac FinalClone.java
FinalClone.java:7: 错误: 无法为 final 变量 items 分配值
            c.items = new ArrayList<>(items);
             ^
A9 获取 Class 对象
Order 的静态语句块打印“Order 初始化”:
class Order { static { System.out.println("  Order 初始化"); } }

Class<?> c1 = Order.class;
Class<?> c2 = Class.forName("Order", false, Get.class.getClassLoader());
Class<?> c3 = Class.forName("Order");
Class<?> c4 = new Order().getClass();
System.out.println("同一个 Class 对象: " + (c1 == c2 && c2 == c3 && c3 == c4));
Order.class
Class.forName("Order", false, ...)
Class.forName("Order")
  Order 初始化
new Order().getClass()
同一个 Class 对象: true
A10 protected 的访问范围
p.A 中声明 protected int x,分别从同一个包的非子类、其它包的非子类、其它包的子类访问:
package p;
public class A { protected int x = 1; }

package q;
public class Sub extends A {
    void ok() { System.out.println(x); Sub s = new Sub(); System.out.println(s.x); }
    void bad(A other) { System.out.println(other.x); }
}
$ javac -d out p/A.java p/SamePkg.java && java -cp out p.SamePkg
same package non-subclass reads x = 1
$ javac -cp out -d out q/OtherPkg.java
q/OtherPkg.java:4: 错误: x 在 A 中是 protected 访问控制
$ javac -cp out -d out q/Sub.java
q/Sub.java:6: 错误: x 在 A 中是 protected 访问控制
  void bad(A other) { System.out.println(other.x); }
删去 bad() 后 Sub 编译通过,ok() 中通过 this 和 Sub 类型的引用都能读到 x。
A11 final 与 static 的初始化
环境:Adoptium JDK 21.0.13,macOS(Apple M1 Pro)。
public class FinalStatic {
    static class Const {
        static final int MAX = 100;            // 编译时常量
        static final Integer BOXED = 100;      // 不是编译时常量
        static { System.out.println("Const 初始化"); }
    }
    static class Holder {
        static { System.out.println("Holder 初始化,线程 " + Thread.currentThread().getName()); }
        static final Object INSTANCE = new Object();
    }

    public static void main(String[] args) throws Exception {
        System.out.println("MAX = " + Const.MAX);
        System.out.println("BOXED = " + Const.BOXED);
        Thread[] ts = new Thread[4];
        for (int i = 0; i < 4; i++) {
            ts[i] = new Thread(() -> Holder.INSTANCE.hashCode(), "t" + i);
            ts[i].start();
        }
        for (Thread t : ts) t.join();
    }
}
MAX = 100
Const 初始化
BOXED = 100
Holder 初始化,线程 t0
读取 MAX 没有触发 Const 的初始化,javap 中 main 对 Const 的 getstatic 只有 BOXED 一条,MAX 已经被替换成常量 100;4 个线程同时访问 Holder,静态语句块只执行了一次,执行它的线程每次运行可能不同。
只在一个分支中给 final 字段赋值时编译报错:
class Blank { final int x; Blank(boolean b) { if (b) x = 1; } }
Blank.java:1: 错误: 可能尚未初始化变量x
参考资料
- Eckel B. Java 编程思想 [M]. 机械工业出版社, 2002.
- Bloch J. Effective Java [M]. Addison-Wesley Professional, 2017.
- JEP 441: Pattern Matching for switch
- JEP 444: Virtual Threads
- JDK 25
- JLS 6.6: Access Control
- PEP 703: Making the Global Interpreter Lock Optional in CPython
- What’s New in Python 3.14
- A Guide to the Go Garbage Collector
- JLS 5.1.7: Boxing Conversion
- JLS 14.20.2: Execution of try-finally and try-catch-finally
- Java SE 21 API: Runtime
- HotSpot 源码:synchronizer.cpp 中的 get_next_hash()
- JLS 4.6: Type Erasure
- JEP 254: Compact Strings
- JEP 361: Switch Expressions
- JEP 396: Strongly Encapsulate JDK Internals by Default
- JEP 500: Prepare to Make Final Mean Final
- JEP 403: Strongly Encapsulate JDK Internals
- JEP 416: Reimplement Core Reflection with Method Handles
- JEP 421: Deprecate Finalization for Removal
- Primitive Data Types
- The Java® Virtual Machine Specification
- Autoboxing and Unboxing
- StackOverflow : Differences between new Integer(123), Integer.valueOf(123) and just 123
- StackOverflow : String, StringBuffer, and StringBuilder
- StackOverflow : What is String interning?
- 深入解析 String#intern
- StackOverflow: Is Java “pass-by-reference” or “pass-by-value”?
- StackOverflow : Why don't Java's +=, -=, *=, /= compound assignment operators require casting?
- StackOverflow : Why can't your switch statement data type be long, Java?
- Abstract Methods and Classes
- 深入理解 abstract class 和 interface(IBM developerWorks 中文站,已下线)
- When to Use Abstract Class and Interface
- Java 9 Features with Examples
- Using the Keyword super
- Trail: The Reflection API
- 深入解析 Java 反射(1)- 基础
- Java Exception Interview Questions and Answers
- Java提高篇——Java 异常处理
- Java 泛型详解
- 10 道 Java 泛型面试题
- 注解 Annotation 实现原理与自定义注解例子